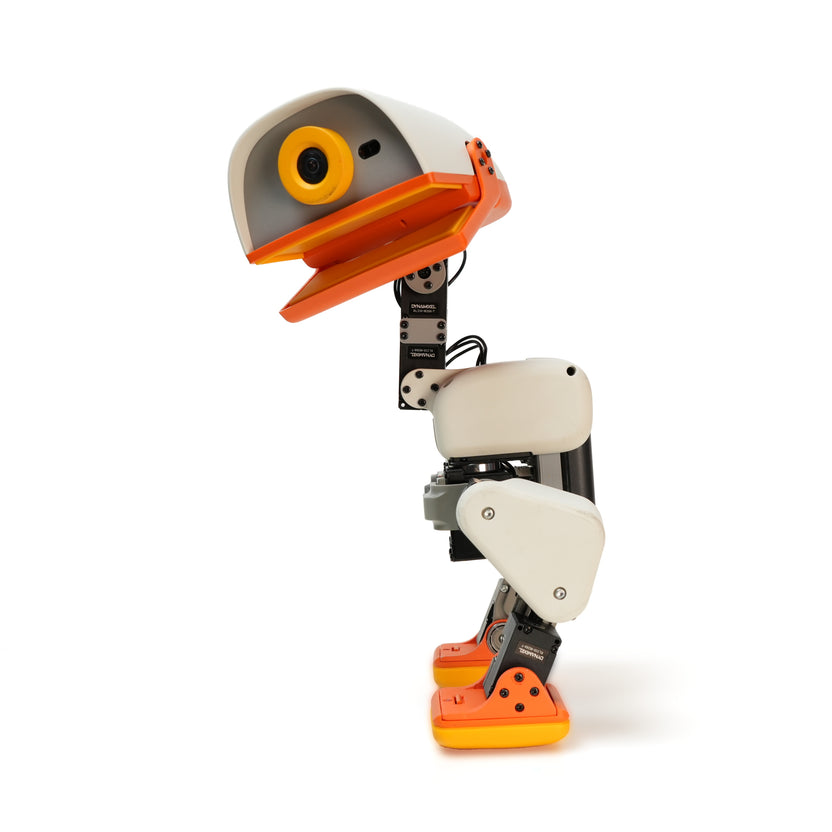
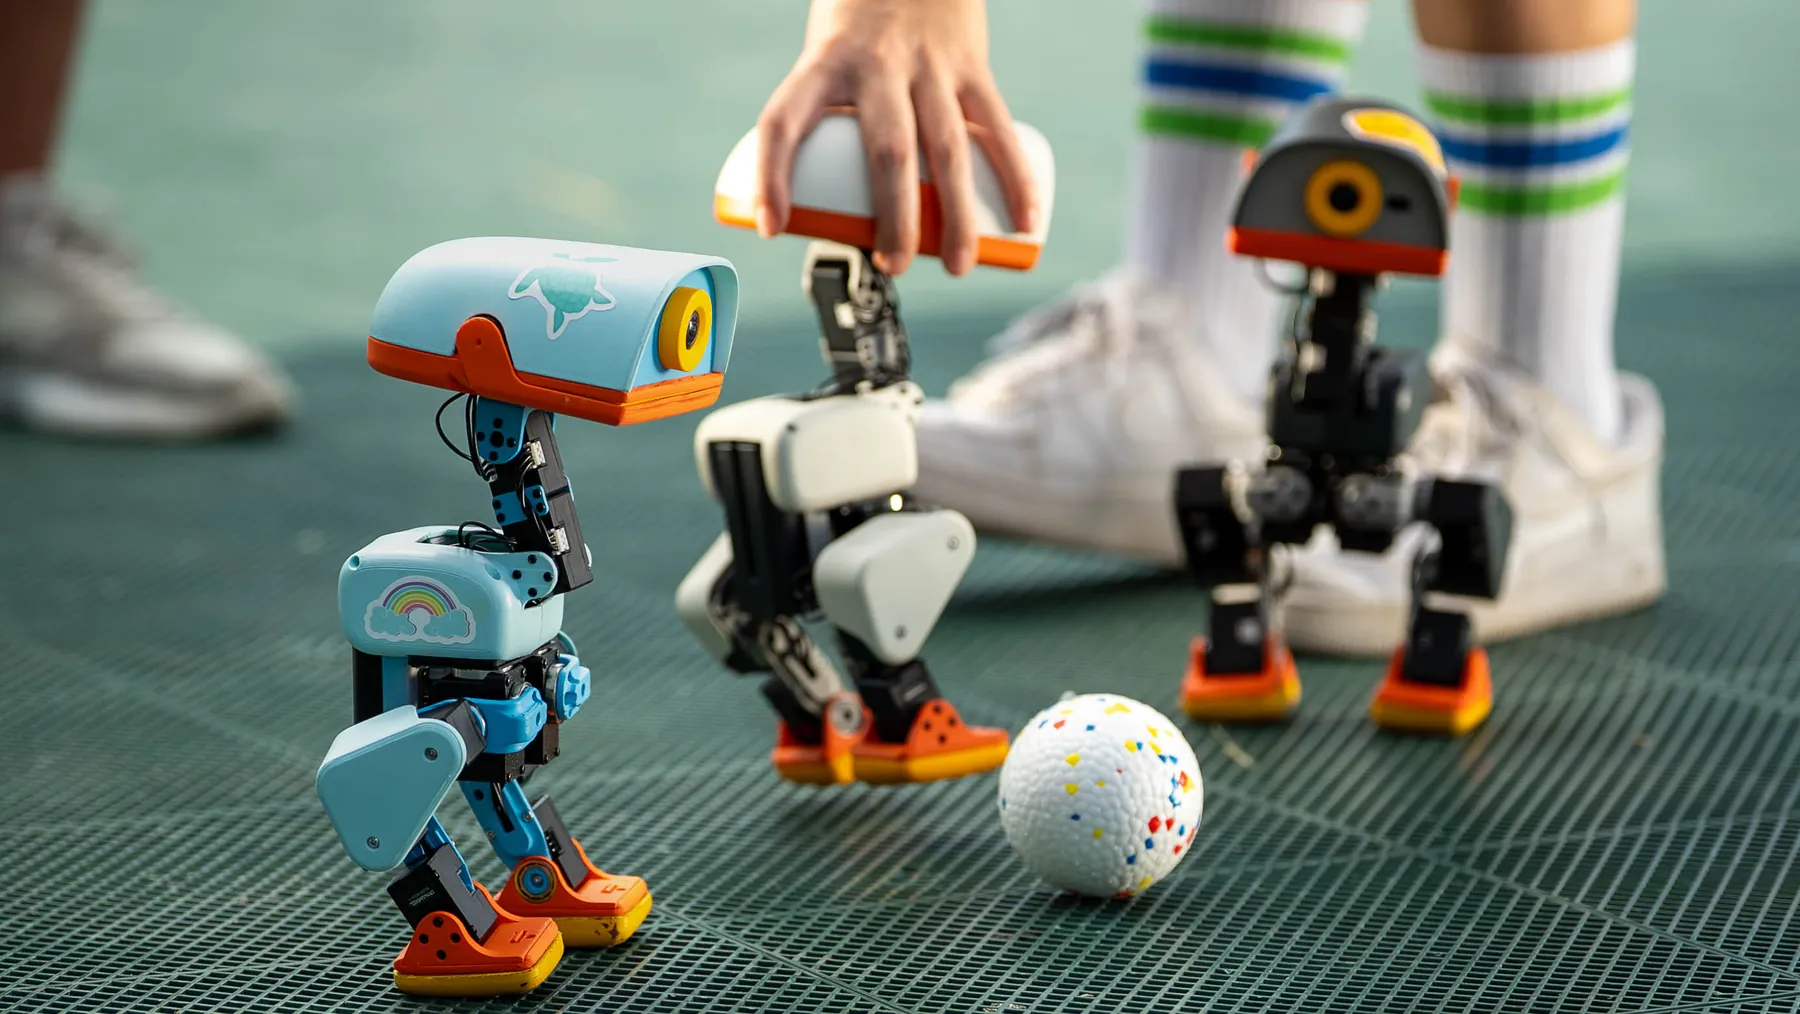
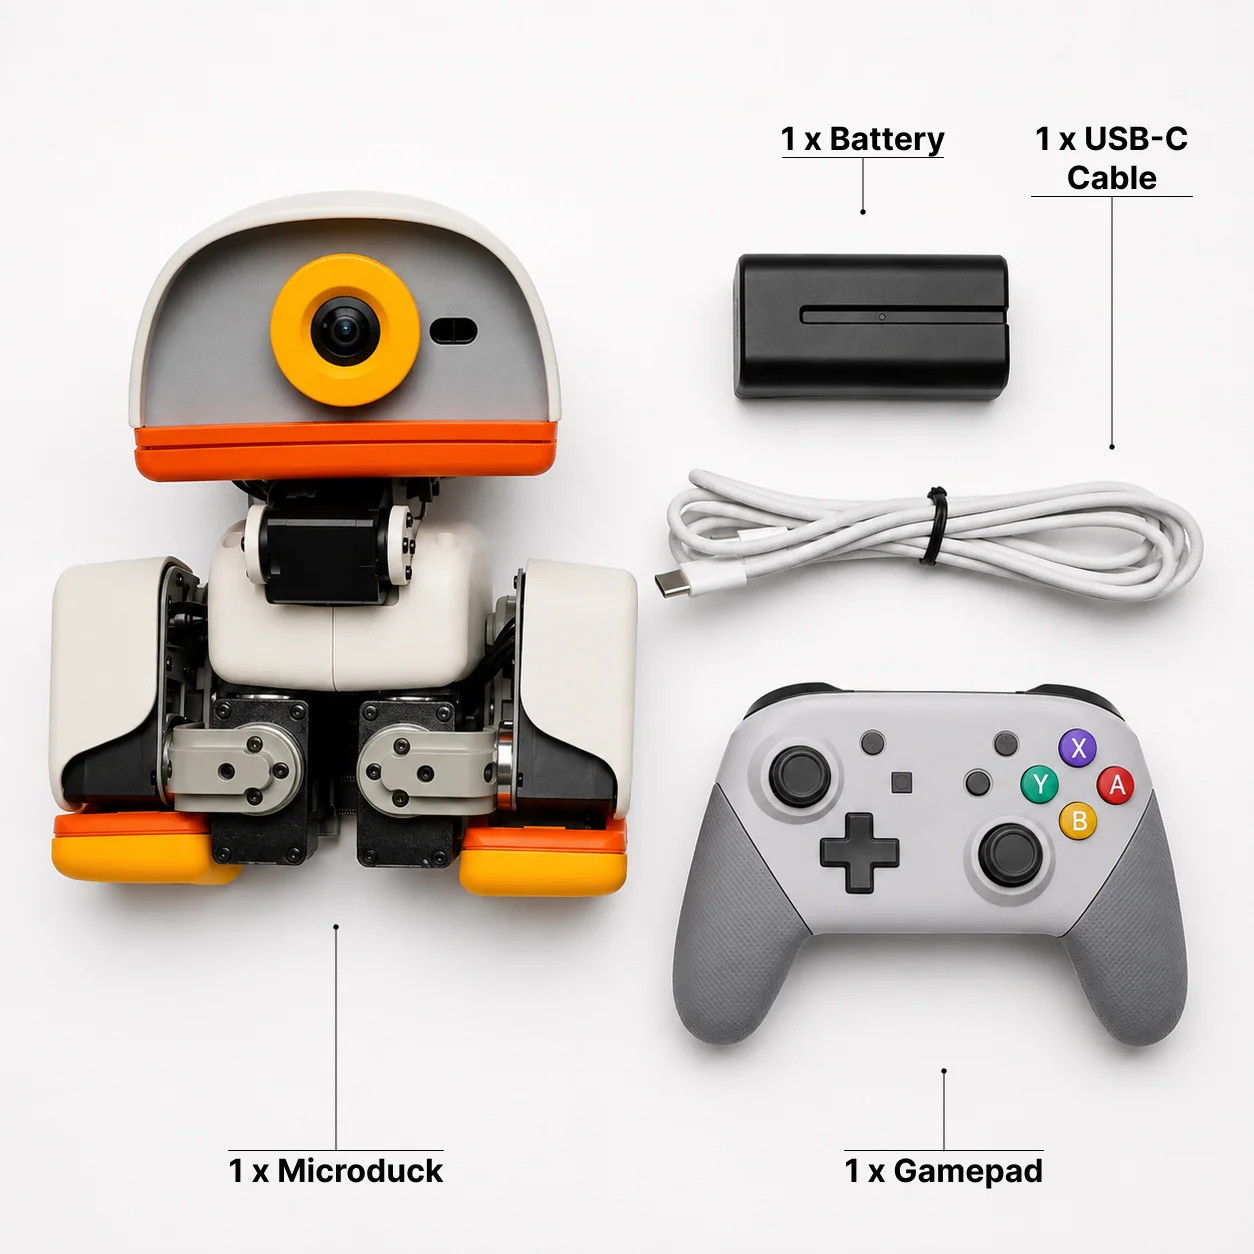
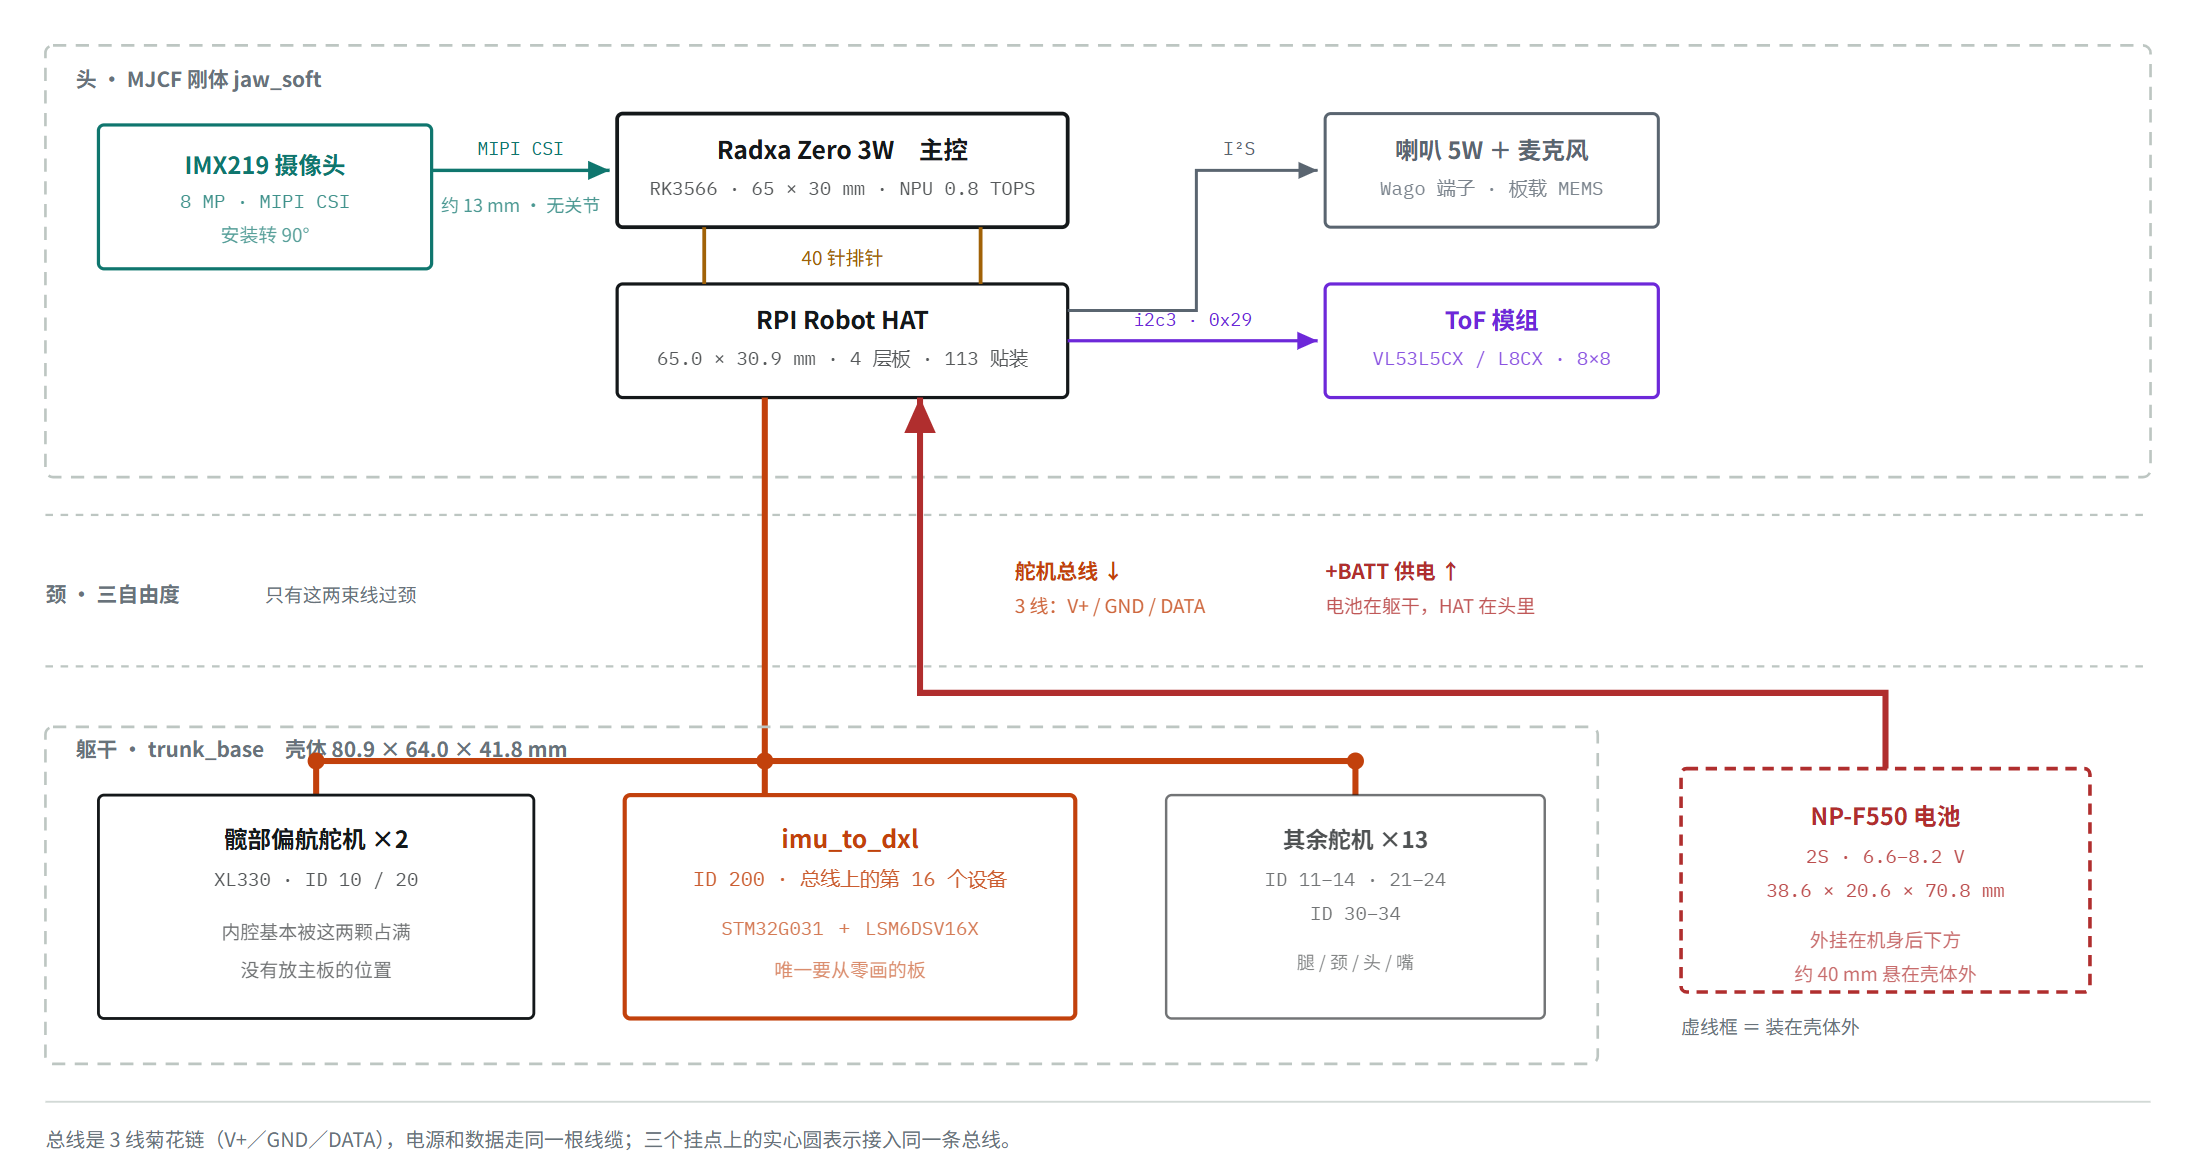
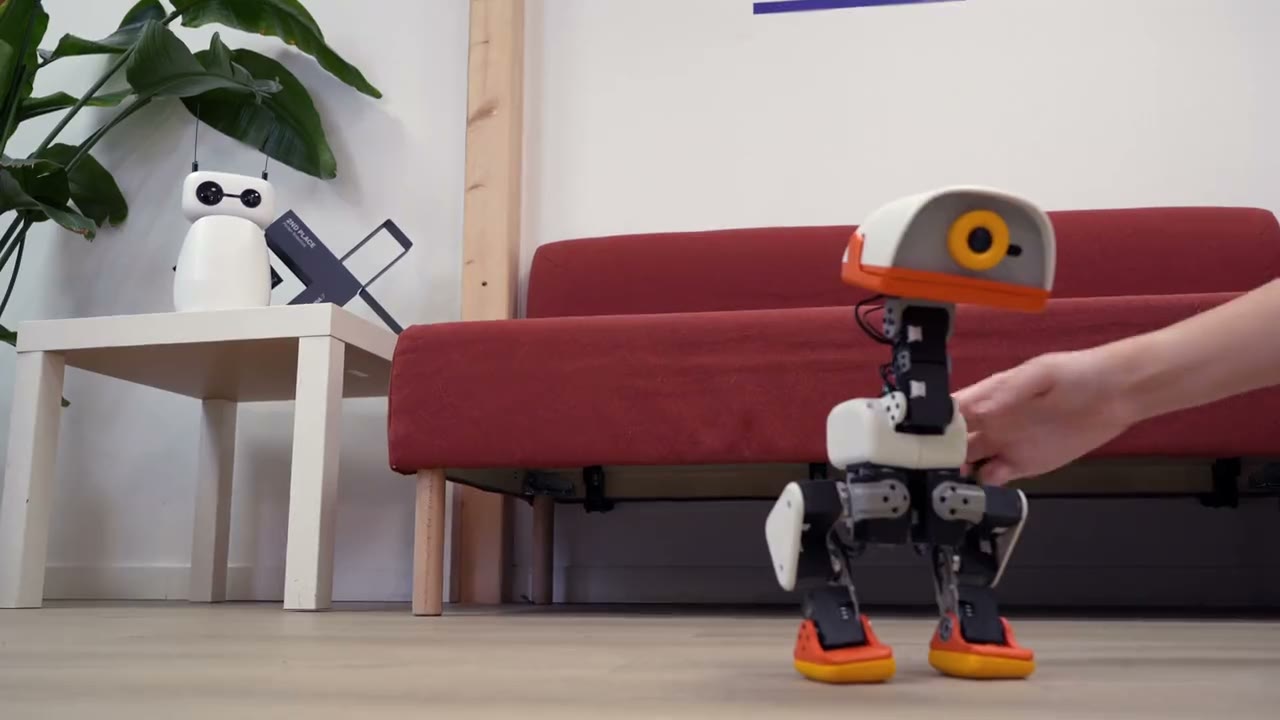
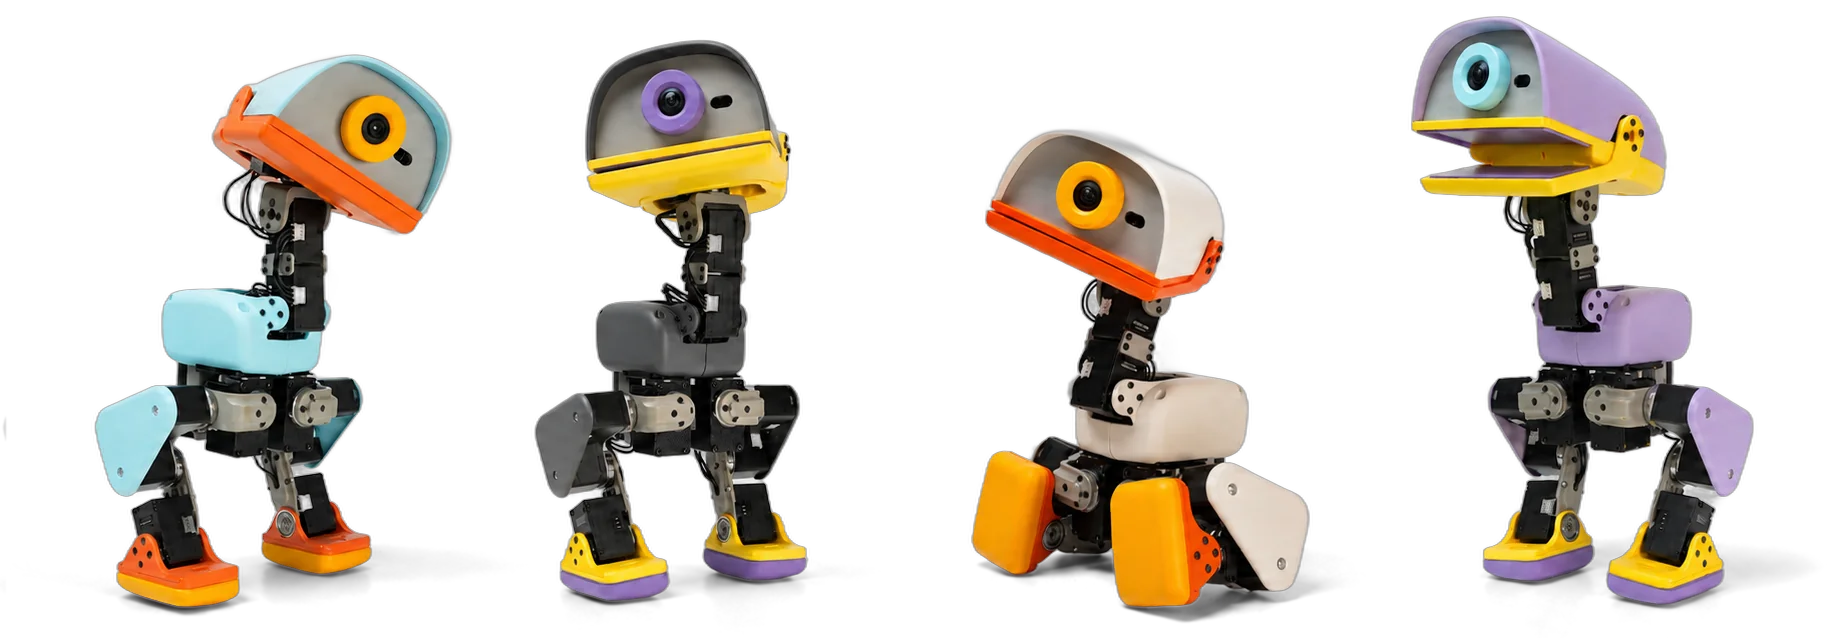
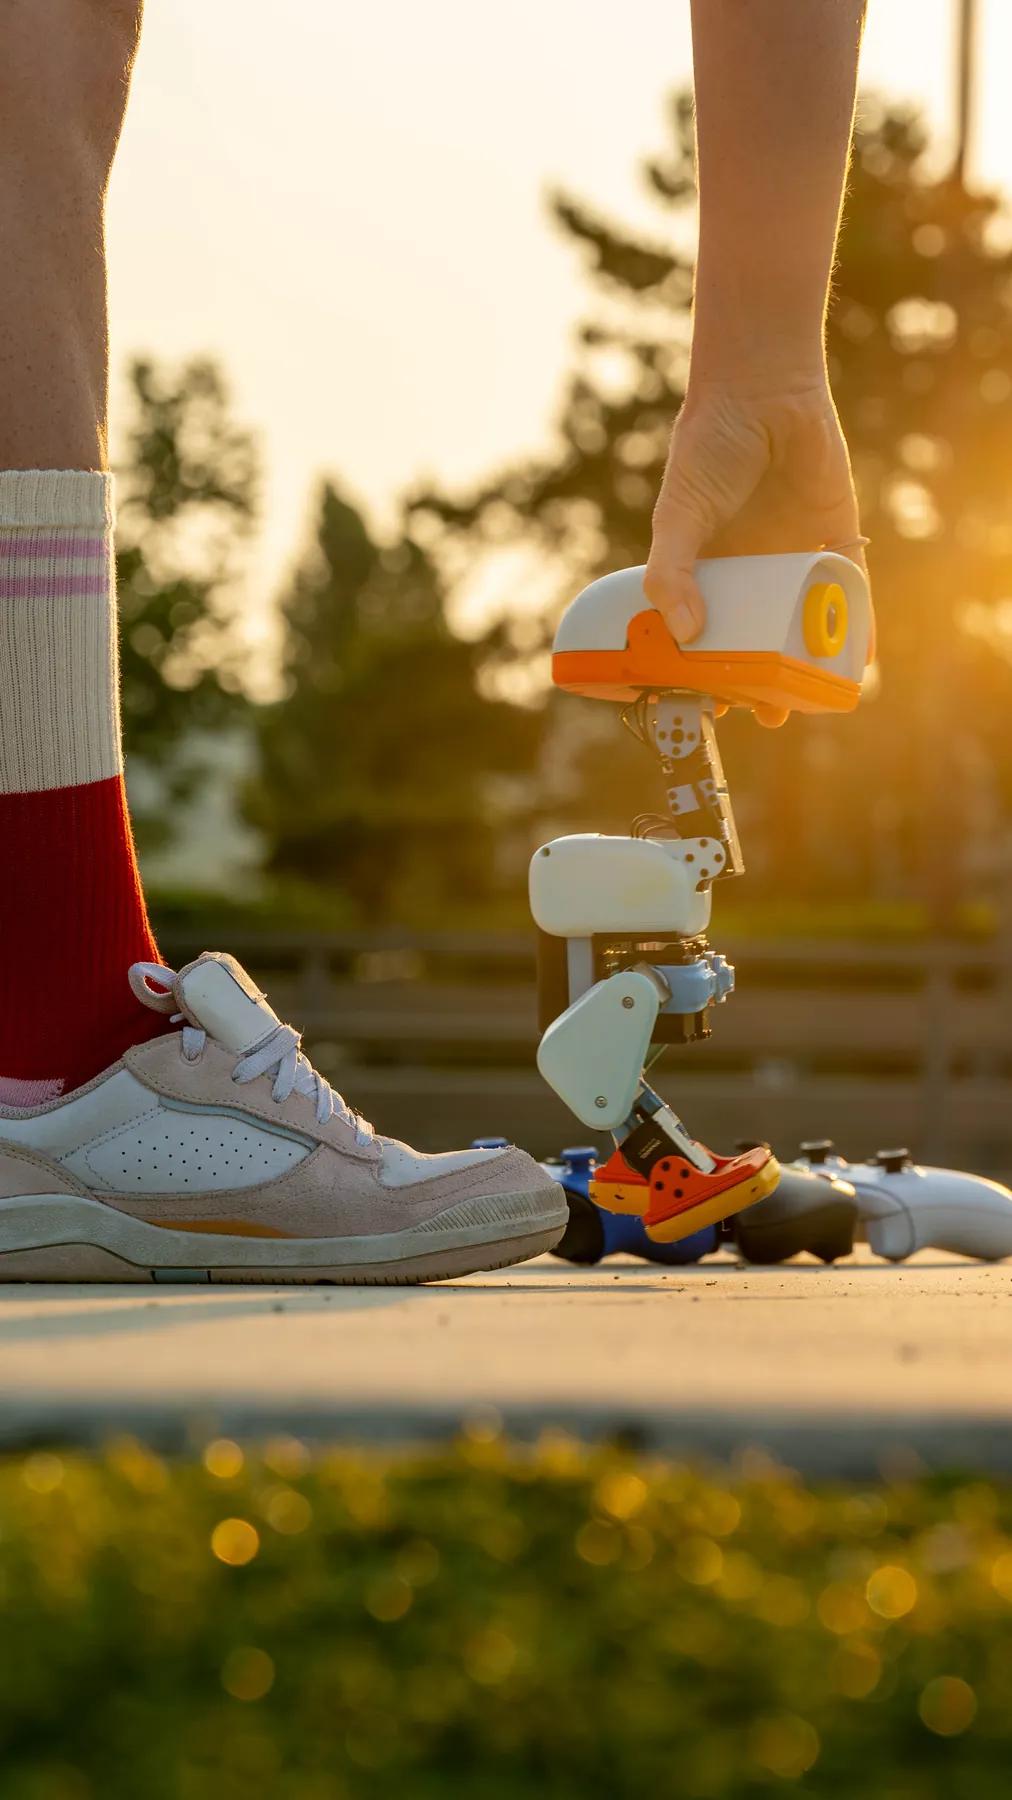
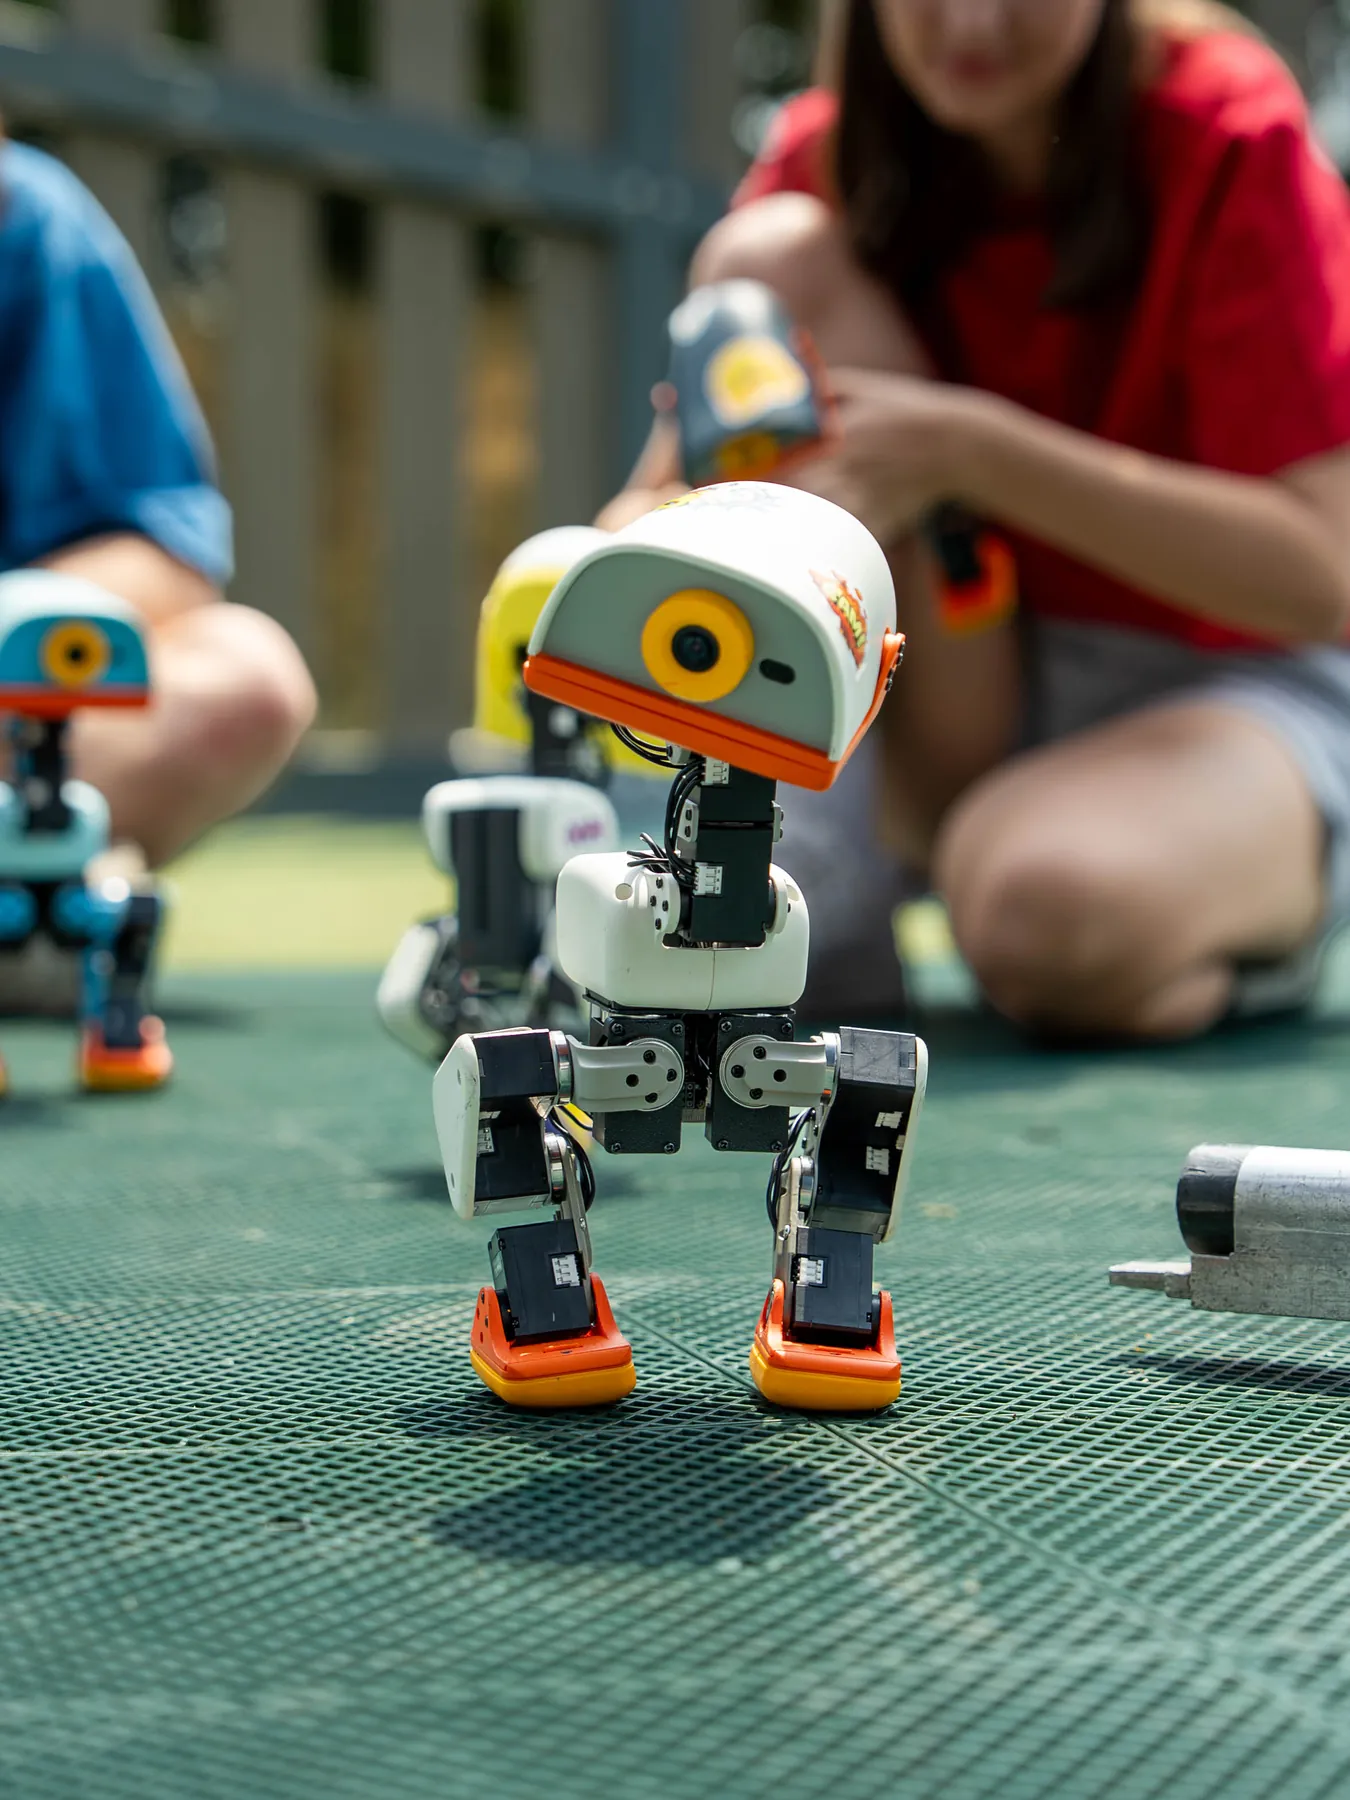
我盯着 Microduck 的预购页看了很久。官方页面写着 25 厘米高、800 克、15 个电机、机身带摄像头加激光雷达和两个 IMU,预购价 399 美元,税前不含运费,2026 年 8 月 27 日开的预购。对一个会走路的双足来说这价不算离谱,可对我这种连舵机型号都背不全的人来说,先掏钱再研究风险有点大。所以我先干了件更划算的事:把它官方那套强化学习仿真在自己电脑上跑起来。
跑完之后的结论先放这儿。如果你只是想看它怎么走、怎么坐站、怎么前滚翻,纯 CPU 就够,不用显卡;要自己训练一套新步态才需要 CUDA。这个区分特别关键,网上不少教程一上来就让你装 CUDA 版 torch,小白照着做,光下 wheel 就一晚上。
官方那两个仓库,分别管什么
官方把项目拆成两个仓库,名字很像,作用完全不同。pollen-robotics/microduck 是机器人的大脑:Rust 写的,跑在 Rockchip RK3566 上,一个 50Hz 控制环驱动十五个舵机,还管无线电、摄像头和升级。pollen-robotics/microduck_rl 才是训练侧:基于 mjlab(MuJoCo Warp)搭仿真环境,用 PPO 训练,50Hz 训练、导出 ONNX,再交给真机加载。
我们要跑的是 microduck_rl 里的 scripts/infer_policy.py。它干的事很朴素:读一个 ONNX 策略文件,在 MuJoCo 里渲染一只鸭子,把你键盘敲的指令喂进去,看它走。
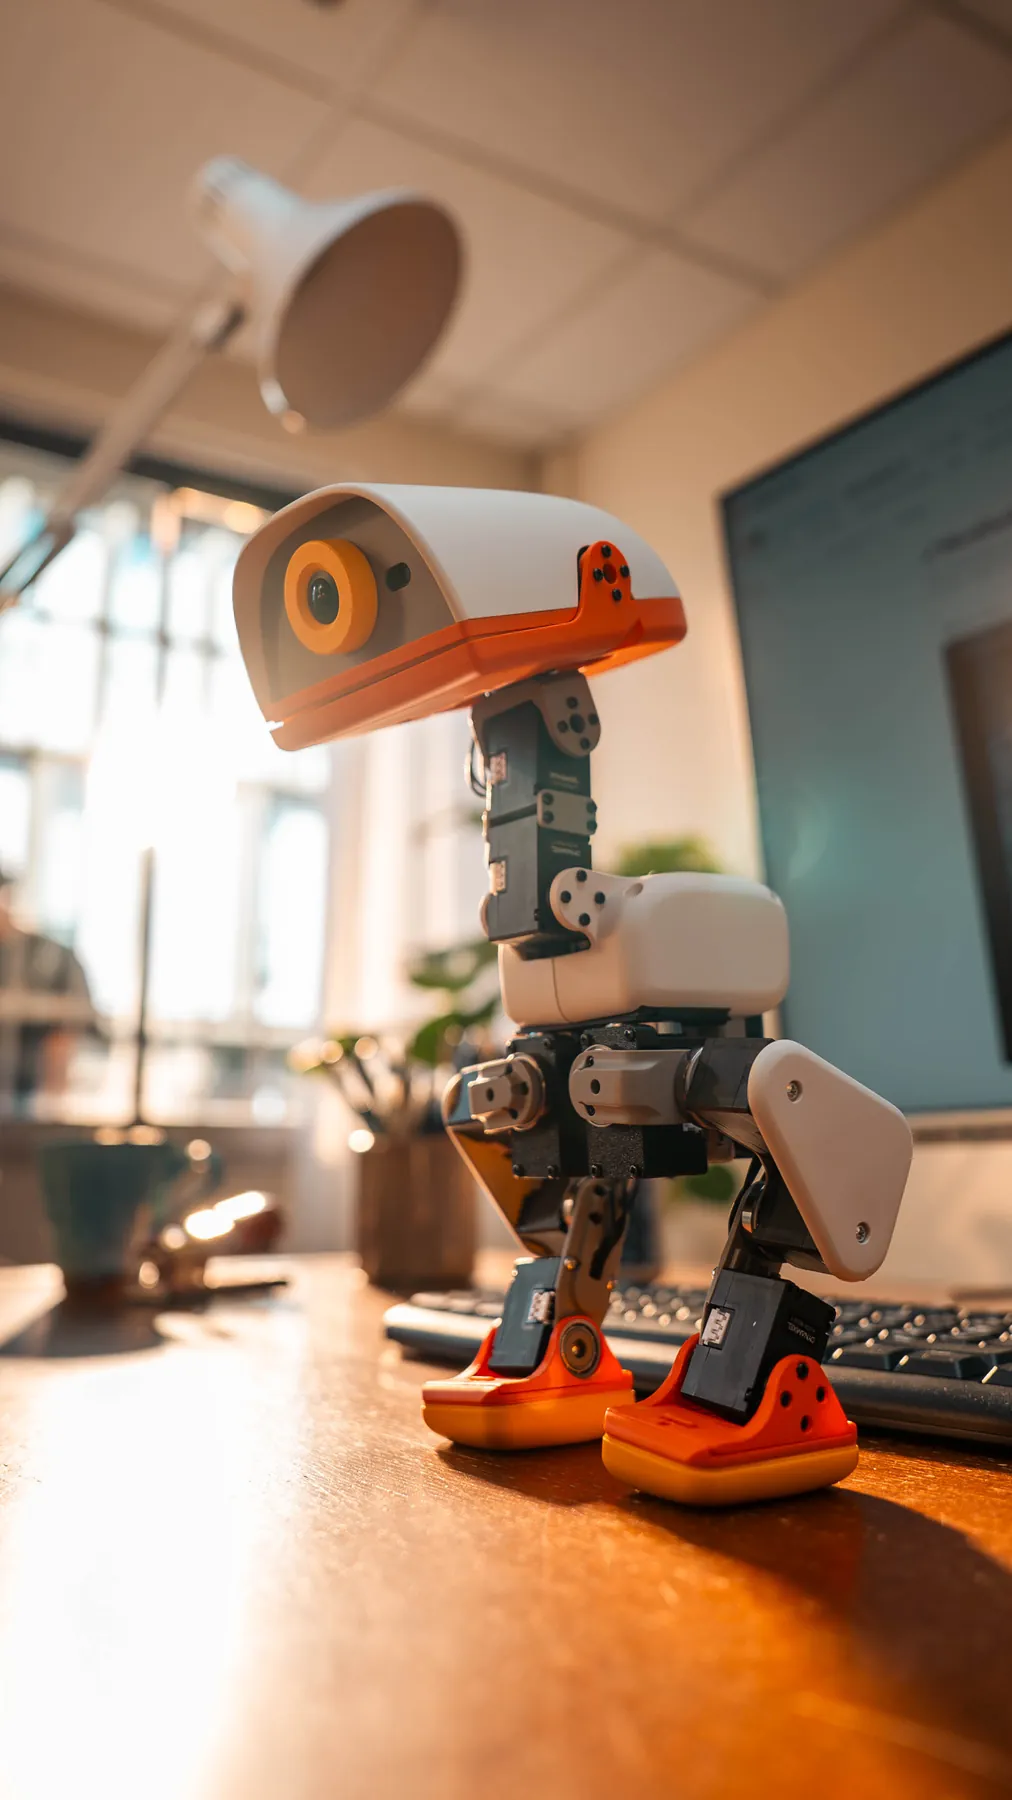
为什么先跑这个?因为它是官方给出的排练场。仓库 README 写得很直白,infer_policy.py 排练的正是真机上那套策略热切换:走路的、站立的、坐站的、前滚翻的,共用一份 61 维观测契约,任何一套都能随时接管机器人。真机上你按一下键看它翻跟头,心里会发慌;仿真里翻坏了,Ctrl+C 就完事。
动手前先记三个数字
第一个是 Python 版本。仓库的 pyproject 里写死 requires-python 为大于等于 3.12 且小于 3.13,注释里讲了原因:bam(更好的执行器模型)要求低于 3.13,而测试基线是 3.12。所以别用 3.13,也别用 3.11。
第二个是版本对齐。pyproject 直接钉死 mjlab 1.3.0、warp-lang 1.12.0、torch 2.9.1、onnxruntime 1.24.4 以上;mujoco 没有直接钉,但注释写明 mjlab 1.3.0 的 mujoco-warp 会锁一个兼容的 mujoco(3.10 这一支)。这几个版本是一条链,随手升级其中一环就断。
第三个是平台。README 的 Quickstart 只有 git clone 加 uv,明确要求 CUDA GPU 和 uv,通篇没出现过 Windows 这个词。这句话不是我吓人,是后面所有坑的根。
按官方 README 走的五步
网上流传的中文教程普遍是 conda 建环境、再 uv sync、再打补丁、再下载模型那一套。我照着官方仓库逐条核了一遍,发现官方根本没有 conda 这一环,也没有单独一条 uv sync 的步骤,uv run 会自己把环境建好。所以下面这五步以仓库为准。
第一步,把仓库拉下来。
git clone https://github.com/pollen-robotics/microduck_rl
拉完先进到 microduck_rl 目录里,后面所有命令都在这个目录下执行。
第二步,装 uv。官方唯一指定的环境工具就是它,没让你装 conda、pipenv 或者 pyenv。这一步的意义在于,后面所有命令都靠 uv run 前缀把依赖跑在项目环境里。
第三步,确认任务注册上了。仓库里所有任务都是通过 mjlab 的 entry point 注册的,跑这条能看到当前注册表,顺带验证环境是否装对。
uv run list-envs
第四步,准备 ONNX 文件。这里必须说句实话:仓库本身不带训练好的 ONNX,infer_policy.py 的 --walking 必须指到一个真实文件。来路有两个,一是官方随机器发布的那套策略,README 里点名为 official set,放在 pollen-robotics/microduck-policies;二是自己训,uv run train 训完用 scripts/export.py 导出。导出这步别偷懒去手转 checkpoint,README 专门警告过:导出器会把观测归一化烘进 ONNX 图里,手转的模型在真机上拿到的是没归一化的观测。
官网的技术参数里有一栏我觉得挺关键:随箱 7 个动作,7 个策略全部公开、可以重训。也就是说你不用从零开始碰运气,官方那套先跑通,再谈自己训。
第五步,开跑。键盘给指令,窗口里就是那只鸭。
uv run scripts/infer_policy.py --walking walk.onnx --standing stand.onnx --sitstand sitstand.onnx --roulade roulade.onnx --new-cmd-obs
按键记一下:方向键给速度,G 触地抓取,Y 坐站,R 前滚翻,K 和 L 左右踢球;加 --debug、--save-csv、--record 可以做 sim2real 对比记录。
顺带说一句另一条路。如果你更想看真机那套 daemon 在仿真里的样子,microduck 仓库里有个 scripts/duck-sim,一个窗口里一只鸭,也能开四个窗口当成四台机器分别登录。它跑的是真机软件栈,跟训练环境是两件事,别混着看。
八个坑,我一个个说
下面这些坑分两类:一类是 Windows 和国内网络带来的,一类是仓库自己注释里记着的。后者最值钱,因为那是官方自己踩过、写在 pyproject 和 README 里的,不是谁猜的。
坑一,conda 和 uv 别叠着用。uv 默认在项目目录建自己的 .venv,conda 激活的是另一套解释器。两边同时存在,最常见的现象是包明明装了,脚本还是 ModuleNotFoundError。官方既然只用 uv,就别给自己加一层,多一层就多一个环境错位的机会。
坑二,Windows 上第一行 import 就挂。infer_policy.py 顶部直接 import termios 和 tty,这两个是 POSIX 专属模块,Windows 的 Python 里没有。它这么写有原因:脚本要从终端读单键(cbreak 模式,不是 raw,这样 Ctrl+C 还能用),键盘监听放在后台线程里,用 select 加 os.read 一个字节一个字节取,方向键的 ESC 加方括号 A、B、C、D 序列被翻成 up、down、left、right。Windows 终端没这套 API,所以是 import 阶段就 ModuleNotFoundError,这不是配置问题,是代码层面不支持。两条路:省事的用 WSL2 开 Ubuntu 跑;要在原生 Windows 跑,就把终端读取那一段换掉,用 msvcrt.kbhit() 轮询加 msvcrt.getwch() 取字符,也能实现单键读取。这是改代码,不是装包能解决的。
坑三,HuggingFace 直连下载。官方策略和模型都放在 HF Hub 上,国内直连经常断在半路。huggingface_hub 支持改端点,把 HF_ENDPOINT 指到镜像再下,比反复重试靠谱得多。
坑四,61 维和 51 维别混用。这套东西有个硬契约:新策略的 ONNX 图是 1 乘 61 进、1 乘 14 出,老的是 51 维。61 等于 48 维本体感觉加 13 维指令,也就是 3 维速度、4 维头部姿态、6 维身体姿态。所以带坐站、踢球、前滚翻这些新策略时,必须加 --new-cmd-obs,不加直接抛 ValueError。发布策略那一步也会校验图,51 维的老策略会被拒。
坑五,train 这个命令名是抢来的。pyproject 的注释里记着 2026 年 8 月 31 日的一次事故:仓库自己的 train 脚本和 mjlab 的 train 同名,同名 console script 是后写的覆盖先写的,如果把仓库那行声明删掉,uv sync 会把文件卸掉,而 mjlab 那份也不会重建,结果 venv 里根本没有 train,uv run train 会去 PATH 上找一个不相干的 train,注释里点名是 liblinear 的。看到 train 跑出莫名其妙的报错,先查这个。
坑六,依赖体积和 ARM 机器。首次同步要拉一整套 CUDA wheel,README 说在 ARM 盒子(DGX Spark、GB10、Jetson)上光 CUDA wheel 就约 2GB,uv 默认 30 秒 HTTP 超时容易中途断,第一次同步要设 UV_HTTP_TIMEOUT 为 600。另外在 linux-aarch64 上,PyPI 给的 torch 是纯 CPU 版,torch.cuda.device_count() 返回 0,mjlab 选 GPU 时会去索引一个空列表,直接 IndexError: list index out of range,注释指向 mjlab/utils/gpu.py 第 70 行。x86 桌面没这问题,因为那里的 wheel 自带 nvidia 的 cu12 依赖。
坑七,模型路径是相对路径。infer_policy.py 里的 XML 写的是 src/mjlab_microduck/robot/microduck/scene.xml 这种相对路径,必须在仓库根目录执行,换个目录就找不到场景文件。它列了几个备选场景:scene.xml 是默认,还有 scene_rollers.xml 走轮滑、scene_ball.xml 带球、scene_ramps.xml 带坡、scene_floor_objects.xml 带地面物件。
坑八,版本别自己改。pyproject 的 override 段有一段血泪注释:有人把 mujoco 强降到 3.4.0,结果缺 mjDSBL_MULTICCD,mujoco-warp 3.8.1 一 import 就崩;删掉 protobuf 那条,bam 会把 protobuf 拉到 4 以下,连带 onnx 降到 1.17.0,那个版本没有现成 wheel,只能源码编译;zmq 那条看着像笔误的写法也不是笔误,bam 依赖的 PyPI 上那个 zmq 桩包 wheel 是坏的,不排除掉就会让 uv sync 在干净环境里直接失败。scipy 同理,mjlab 1.3.0 自己忘了声明 scipy,仓库补了一行,删了连 import 都过不去。
硬件门槛到底在哪
说回我这种小白最关心的钱。推理这条路吃的是 onnxruntime 加 MuJoCo 渲染,普通笔记本能扛。仓库没给推理的内存和 CPU 门槛数字,只给了训练的要求,所以我不瞎报数字,能跑多快取决于你的机器和渲染帧率。
训练才是显卡的门。README 写着训练跑在 MuJoCo Warp 上,需要 CUDA GPU,4096 个并行环境跑一到两小时能出一个能用的步态。没有显卡也不是死路,加 --hf-jobs 可以把训练丢到 Hugging Face Jobs 上跑。
顺手算笔账。399 美元是裸机,官方还有 39 美元的充电包、119 美元的开发包(3 个备用电机、5 根电机线、2 块电池、双充、10 个 NFC 标签、螺丝刀等)、39 美元的配件包。真要动手改,开发包里那 3 个备用电机不是可选项,小舵机驱动 800 克的双足,扫齿是常态。另外想玩轮滑那几个任务,得先有配件包里那对轮子,那 39 美元躲不掉。
跑通之后,能做什么、不能做什么
能做的事比我想的多。仓库注册的任务表里,速度跟踪有平地和粗糙地形两档,还有从趴着、仰着、坐着的姿势自己站起来并保持站立、指令坐站、低头触地、踢一个 70 毫米 15 克的小球、前滚翻、轮滑速度跟踪、八字滑、蹲着滑、下坡滑、轮上站起来、原地快转。每个主任务还有一个 Backlash 版本,在 14 个舵机关节上串 ±1 度的齿隙。仿真里这些都能用键盘调出来看。
不能做的事也得说清楚。第一,它不能替你做 sim2real 的判断。仓库自己承认,这个尺度上执行器保真度就是 sim2real 差距的大头,所以把 BAM 的 M6 模型做到了电压控制律这一层,管电压控制、反电动势、库仑和 Stribeck 摩擦还有负载相关摩擦,训练时还随机化电池电压、负载压降、指令延迟。你在仿真里看到稳,不代表真机稳。
第二,它不训练策略。infer_policy.py 是排练工具,训练走 train 那条路,两件事别混。
第三,它替代不了真机。加速度计读数是仿真给的,没有真机的振动和漂移;球是场景里摆好的,踢球前脚本会按训练时的重置逻辑把球放到脚前,不是真的滚过来。
所以我把这事分成两段:先用一个下午把仿真跑起来,看它的动作、看观测维度、看键盘响应,把“这东西值不值 399 美元”变成一个具体判断;真觉得有意思,再考虑买。至于要不要训自己的策略,等你看完它走路再说,训练要显卡,要一到两小时一轮,还得接受训出来的步态可能很难看。
我卡最久的地方不是环境,是 Windows 那个 termios。想省事的直接 WSL2,别跟我一样在原生 Windows 上折腾半宿。