
249 美元能买到什么样的边缘 AI 算力?NVIDIA 给出的答案是 Jetson Orin Nano Super Developer Kit:一块巴掌大的开发板,官方规格页标着 67 INT8 TOPS,官方博客的定位是"最具性价比的生成式 AI 计算机"。我照复现项目的老习惯,把官方产品页、数据表和技术博客挨个翻了一遍,参数逐项对过,这篇拆开讲它到底值不值。
先交代一个背景:这块板子不是新硬件,而是 2024 年 12 月 NVIDIA 用一次纯软件更新"点化"出来的 Super 版本,官方标价同时从 499 美元降到 249 美元。截至 10 月 31 日,NVIDIA 官网仍标 249 美元,通过全球授权分销商发售。
Super 从哪来:一半是硬件,一半是电源模式
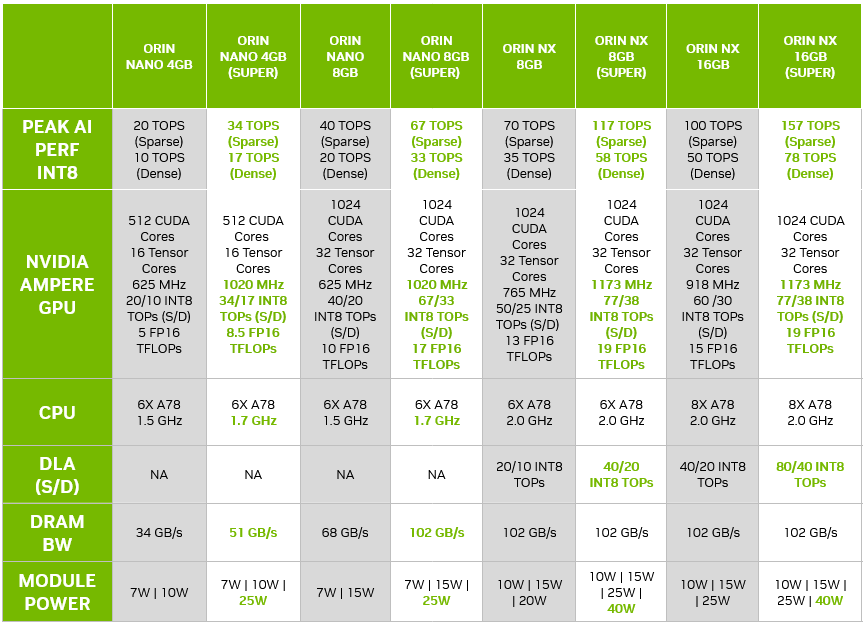
那波更新里 NVIDIA 没换模组,靠一套新的电源模式把频率整体拉高:GPU 从 635 MHz 提到 1020 MHz,CPU 从 1.5 GHz 提到 1.7 GHz,内存带宽从 68 GB/s 提到 102 GB/s,稀疏算力从 40 TOPS 涨到 67 TOPS,官方口径是生成式 AI 性能最高提升 1.7 倍。
这意味着两件事:一是手上已有老款 Jetson Orin Nano 开发套件的人,升级到对应版本的 JetPack 就能白拿这波性能;二是它的散热、供电和载板设计与老款一致,二手市场淘来的老套件一样能刷成 Super,这点对预算紧张的玩家挺友好。
规格逐项拆:8GB 统一内存是分水岭
| 项目 | 参数(官方口径) | 复现员点评 |
|---|---|---|
| AI 性能 | 67 INT8 TOPS(稀疏),33 TOPS(密集),FP16 下 17 TFLOPs | 稀疏值别当密集算力用 |
| GPU | Ampere 架构,1024 个 CUDA 核心 + 32 个 Tensor Core,1020 MHz | CUDA 生态是核心卖点 |
| CPU | 6 核 Arm Cortex-A78AE v8.2,1.7 GHz,1.5MB L2 + 4MB L3 | 控制类任务绰绰有余 |
| 内存 | 8GB 128-bit LPDDR5,102 GB/s | Q4 量化 8B 模型的上限 |
| 存储 | SD 卡槽 + 外接 NVMe | 跑模型建议直接上 NVMe |
| 功耗 | 7W / 15W / 25W 三档(模组) | 25W 档才跑得出 67 TOPS |
8GB 128-bit LPDDR5 是整套配置真正的分水岭:Q4 量化后 7B 到 8B 的模型塞得下,但要同时挂一个视觉模型做机器人感知,就得在上下文长度和模型尺寸上精打细算。存储官方只给了 SD 卡槽加外接 NVMe,想认真跑模型建议直接配 NVMe,SD 卡的随机读写撑不住反复加载。模组侧还支持 SD 卡之外的扩展,整机套件自带风扇和散热件。
官方跑分怎么看:小模型受益最大
官方博客给了一组 MLC INT4 量化下的生成速度:Llama 3.1 8B 从 14 提到 19.14 token/s(1.37 倍),Llama 3.2 3B 从 27.7 提到 43.07 token/s(1.55 倍),Qwen2.5 7B 从 14.2 提到 21.75 token/s(1.53 倍)。视觉侧,CLIP ViT-B/32 用 TensorRT FP16 从 196 FPS 提到 314 FPS,分割模型 SAM2 base 从 4.42 FPS 提到 6.34 FPS。
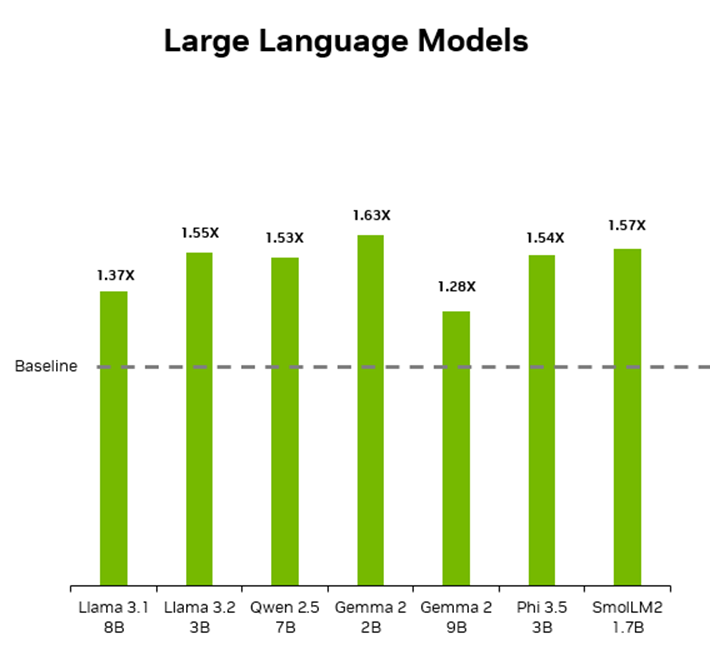
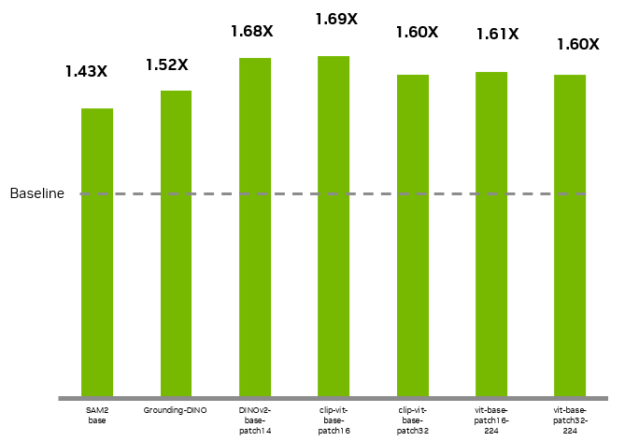
我的读法有三条:3B 级小模型的提速幅度普遍比 8B 大,做嵌入式视觉和轻量对话优先选小模型;8B 模型 20 token/s 上下的生成速度,本地问答够用,别指望它流畅写长文;这批数字全部出自官方自测,社区复现普遍略低一点,下单前心里留个折扣。
上手链路:一条命令开 Super 模式
复现链路照官方文档走:先用 JetPack 的 SD 卡镜像或 SDK Manager 烧录,Super 性能从 JetPack 6.1 起带入,6.2 把 Super 模式正式铺到 Orin Nano 和 Orin NX 系列模组。开机后切 MAXN SUPER 只要一条命令,也可以在 Ubuntu 顶栏的 Power Mode Selector 里点选:
sudo nvpmodel -m 2提醒一句:忘切电源模式,跑分能差出一大截,官方基准数据都是在 25W 档测的。JetPack 现在已经迭代到 7.x,官方 JetPack 页面写明支持 Orin 和 Thor 平台,这块板子的软件生命周期不用愁,官方博客还提过 Orin 产品线会延到 2032 年。
框架生态是它和普通单板机拉开差距的地方:Hugging Face Transformers、llama.cpp、vLLM、MLC、TensorRT-LLM、Ollama 在 Jetson 上都有现成的 CUDA 构建,云端那套推理栈基本能原样搬到板子上,依赖装起来不算折腾。
玩家能拿它做什么
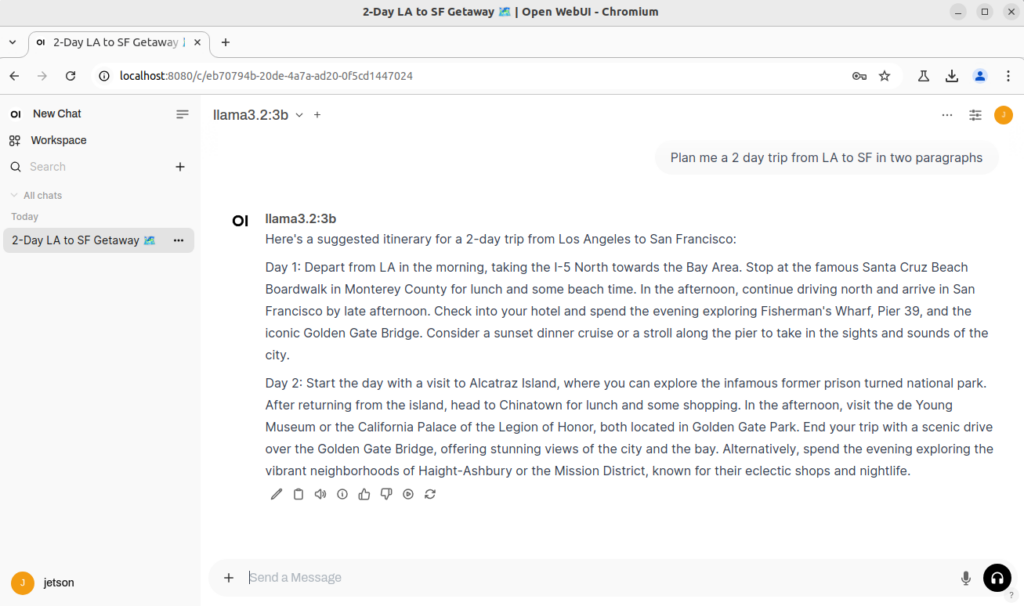
两条现成的路。第一条是本地知识库:Ollama 加 Open WebUI 搭一个带检索增强的聊天机器人,官方有完整教程,跑个 llama3.2 3B 这类小模型开箱即用,界面长下面这样。
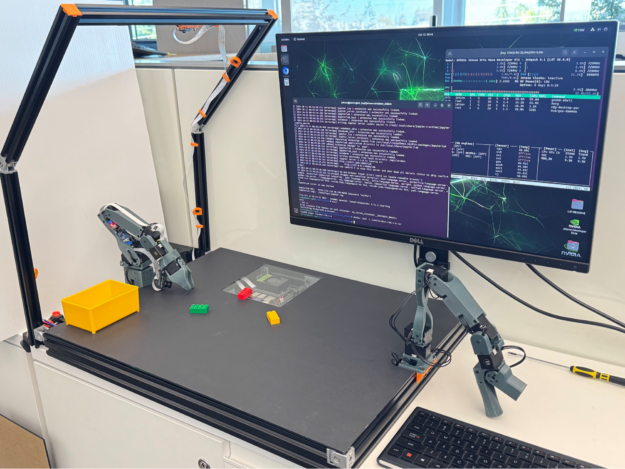
第二条是给机器人当大脑:NVIDIA 和 Hugging Face 合作的 LeRobot 教程可以直接在这块板上跑,用视觉输入和历史轨迹预测动作,玩桌面机械臂模仿学习的可以把它当算力盒子。再往上游,Jetson AI Lab 上有近 50 个教程和预构建容器,NanoOWL 开放词汇检测、NanoDB 图像检索这类项目照着文档就能复现。
值不值:和树莓派 5 摆在一起看
很多人会拿它和树莓派 5 比。树莓派 5 是通用单板机,官方没有给 AI 算力指标,跑视觉模型主要靠 CPU 硬扛,想加速得另配 AI 加速套件;Orin Nano Super 这边 1024 个 CUDA 核心加 Tensor Core 是原生自带的,跑 Transformer 类模型是设计目标而不是外挂。反过来,纯做控制、接线、学 Linux 的活,树莓派的社区资料更厚,Jetson 的烧录链路对新手反而更重。
两类人建议绕开:只想跑灯带、循迹小车这类轻控制,几十块的主控更划算;想在本地跑 13B 以上大模型的,8GB 内存装不下,得往上走 Orin NX 或 AGX Orin。
结论:249 美元(截至 10 月 31 日官方标价)换来 67 TOPS 算力和一整套 CUDA 生态,对想给机器人加大脑、想在家里跑本地大模型的玩家,这是目前门槛最低的一条路;老 Orin Nano 用户先刷系统,再决定要不要为"Super"这个名头掏钱。










问一下各位,SD卡跑模型加载是不是真的很慢?打算直接配个NVMe,预算又得多几十块。
249美元这个价位确实卡得准,之前499的时候一直劝退,降到249我身边好几个人都下单了。老板子刷个系统就变Super这点是真的良心。
算了个账:8B模型20 token/s左右,本地问答够用,写长文还是得云。不过拿它给小车加个大脑,比再买块NVIDIA显卡划算多了。
提醒得很对,nvpmodel不切25W档跑分差一大截,我第一次测还以为板子是假的,后来才发现默认是15W模式。
树莓派5对比那段说到点子上了,一个走通用一个走AI,看需求选。想跑本地大模型的就不用犹豫了。