
259 美元的边缘 AI 设备,靠一次软件升级把算力从 40 TOPS 拉到 67 TOPS,这件事本身就值得拆开看。今天研究的对象是 NVIDIA Jetson Orin Nano 开发套件——确切说,是升级成"Super"之后的版本。我把官方用户指南、产品页和发布时那篇技术博客逐页点开对了一遍,这篇只做一件事:把模组、载板、算力功耗这三笔账算清楚。
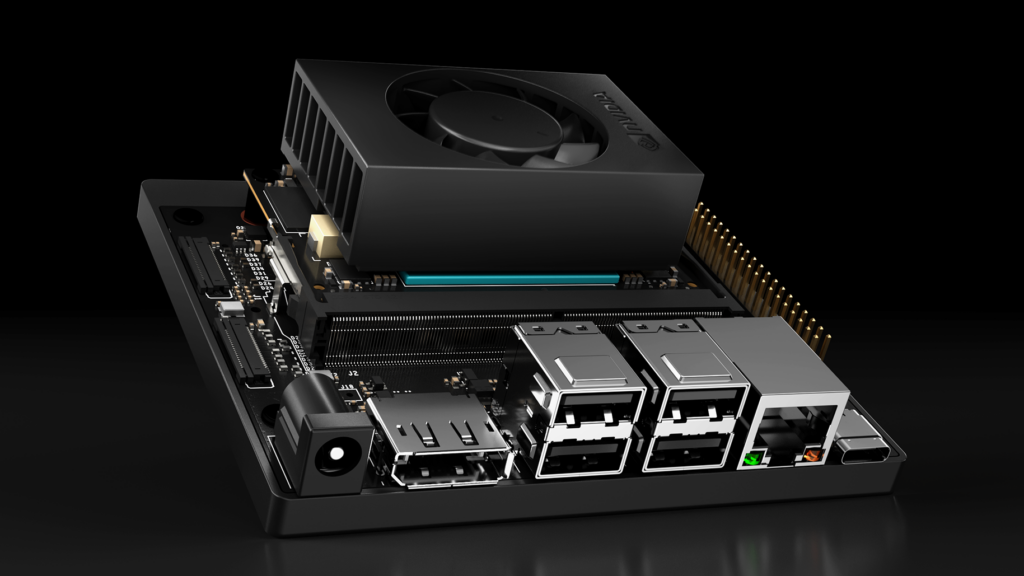
官方渲染图:Jetson Orin Nano 开发套件整包形态,模组加散热风扇预装在载板上
先分清两个东西:模组和载板
很多人把这块板子当成"一块开发板",其实它是两层结构的组合。上层是 Jetson Orin Nano 8GB 模组,即 SoM(系统级模组),NVIDIA 官方博客写得很明白:开发套件由一个 Jetson Orin Nano 8GB 模组和一块参考载板组成,这块载板能兼容所有 Orin Nano 和 Orin NX 系列模组。下层才是那块 100 mm × 79 mm × 21 mm 的参考载板。
模组本体按官方规格页的数据是:Ampere 架构 GPU,1024 个 CUDA 核心加 32 个 Tensor 核心;CPU 是 6 核心 Arm Cortex-A78AE v8.2 64 位处理器,1.5MB L2 加 4MB L3;内存 8GB 128 位 LPDDR5。Super 模式下内存带宽 102 GB/s,CPU 频率 1.7 GHz。这个带宽值是个关键升级点——原版是 68 GB/s,Super 把内存频率一起拉高了,所以生成式 AI 的提升不只靠算力,喂模型的吞吐也在涨。
这个设计思路对选型很实用:买开发套件做原型,量产时直接换模组贴自己的载板,NVIDIA 把"参考设计"这层风险替你担了。
算力这笔账:40 到 67 TOPS 差在哪
原版 Orin Nano 模组标 40 INT8 TOPS,官方博客当时的说法是比上一代 Jetson Nano 提升 80 倍。2024 年底 NVIDIA 用 JetPack 软件升级把功率上限放开,Super 模式做到 67 INT8 TOPS,官方给的提升幅度是 1.7 倍。用户指南里明确写了:现有的 Orin Nano 开发套件用户升级软件就能拿到 Super 性能——也就是说,算力提升是官方超频加调度的结果,硬件没有变。
官方性能对比图:Jetson Orin Nano 与上一代 Jetson Nano 的生成式 AI 性能对比
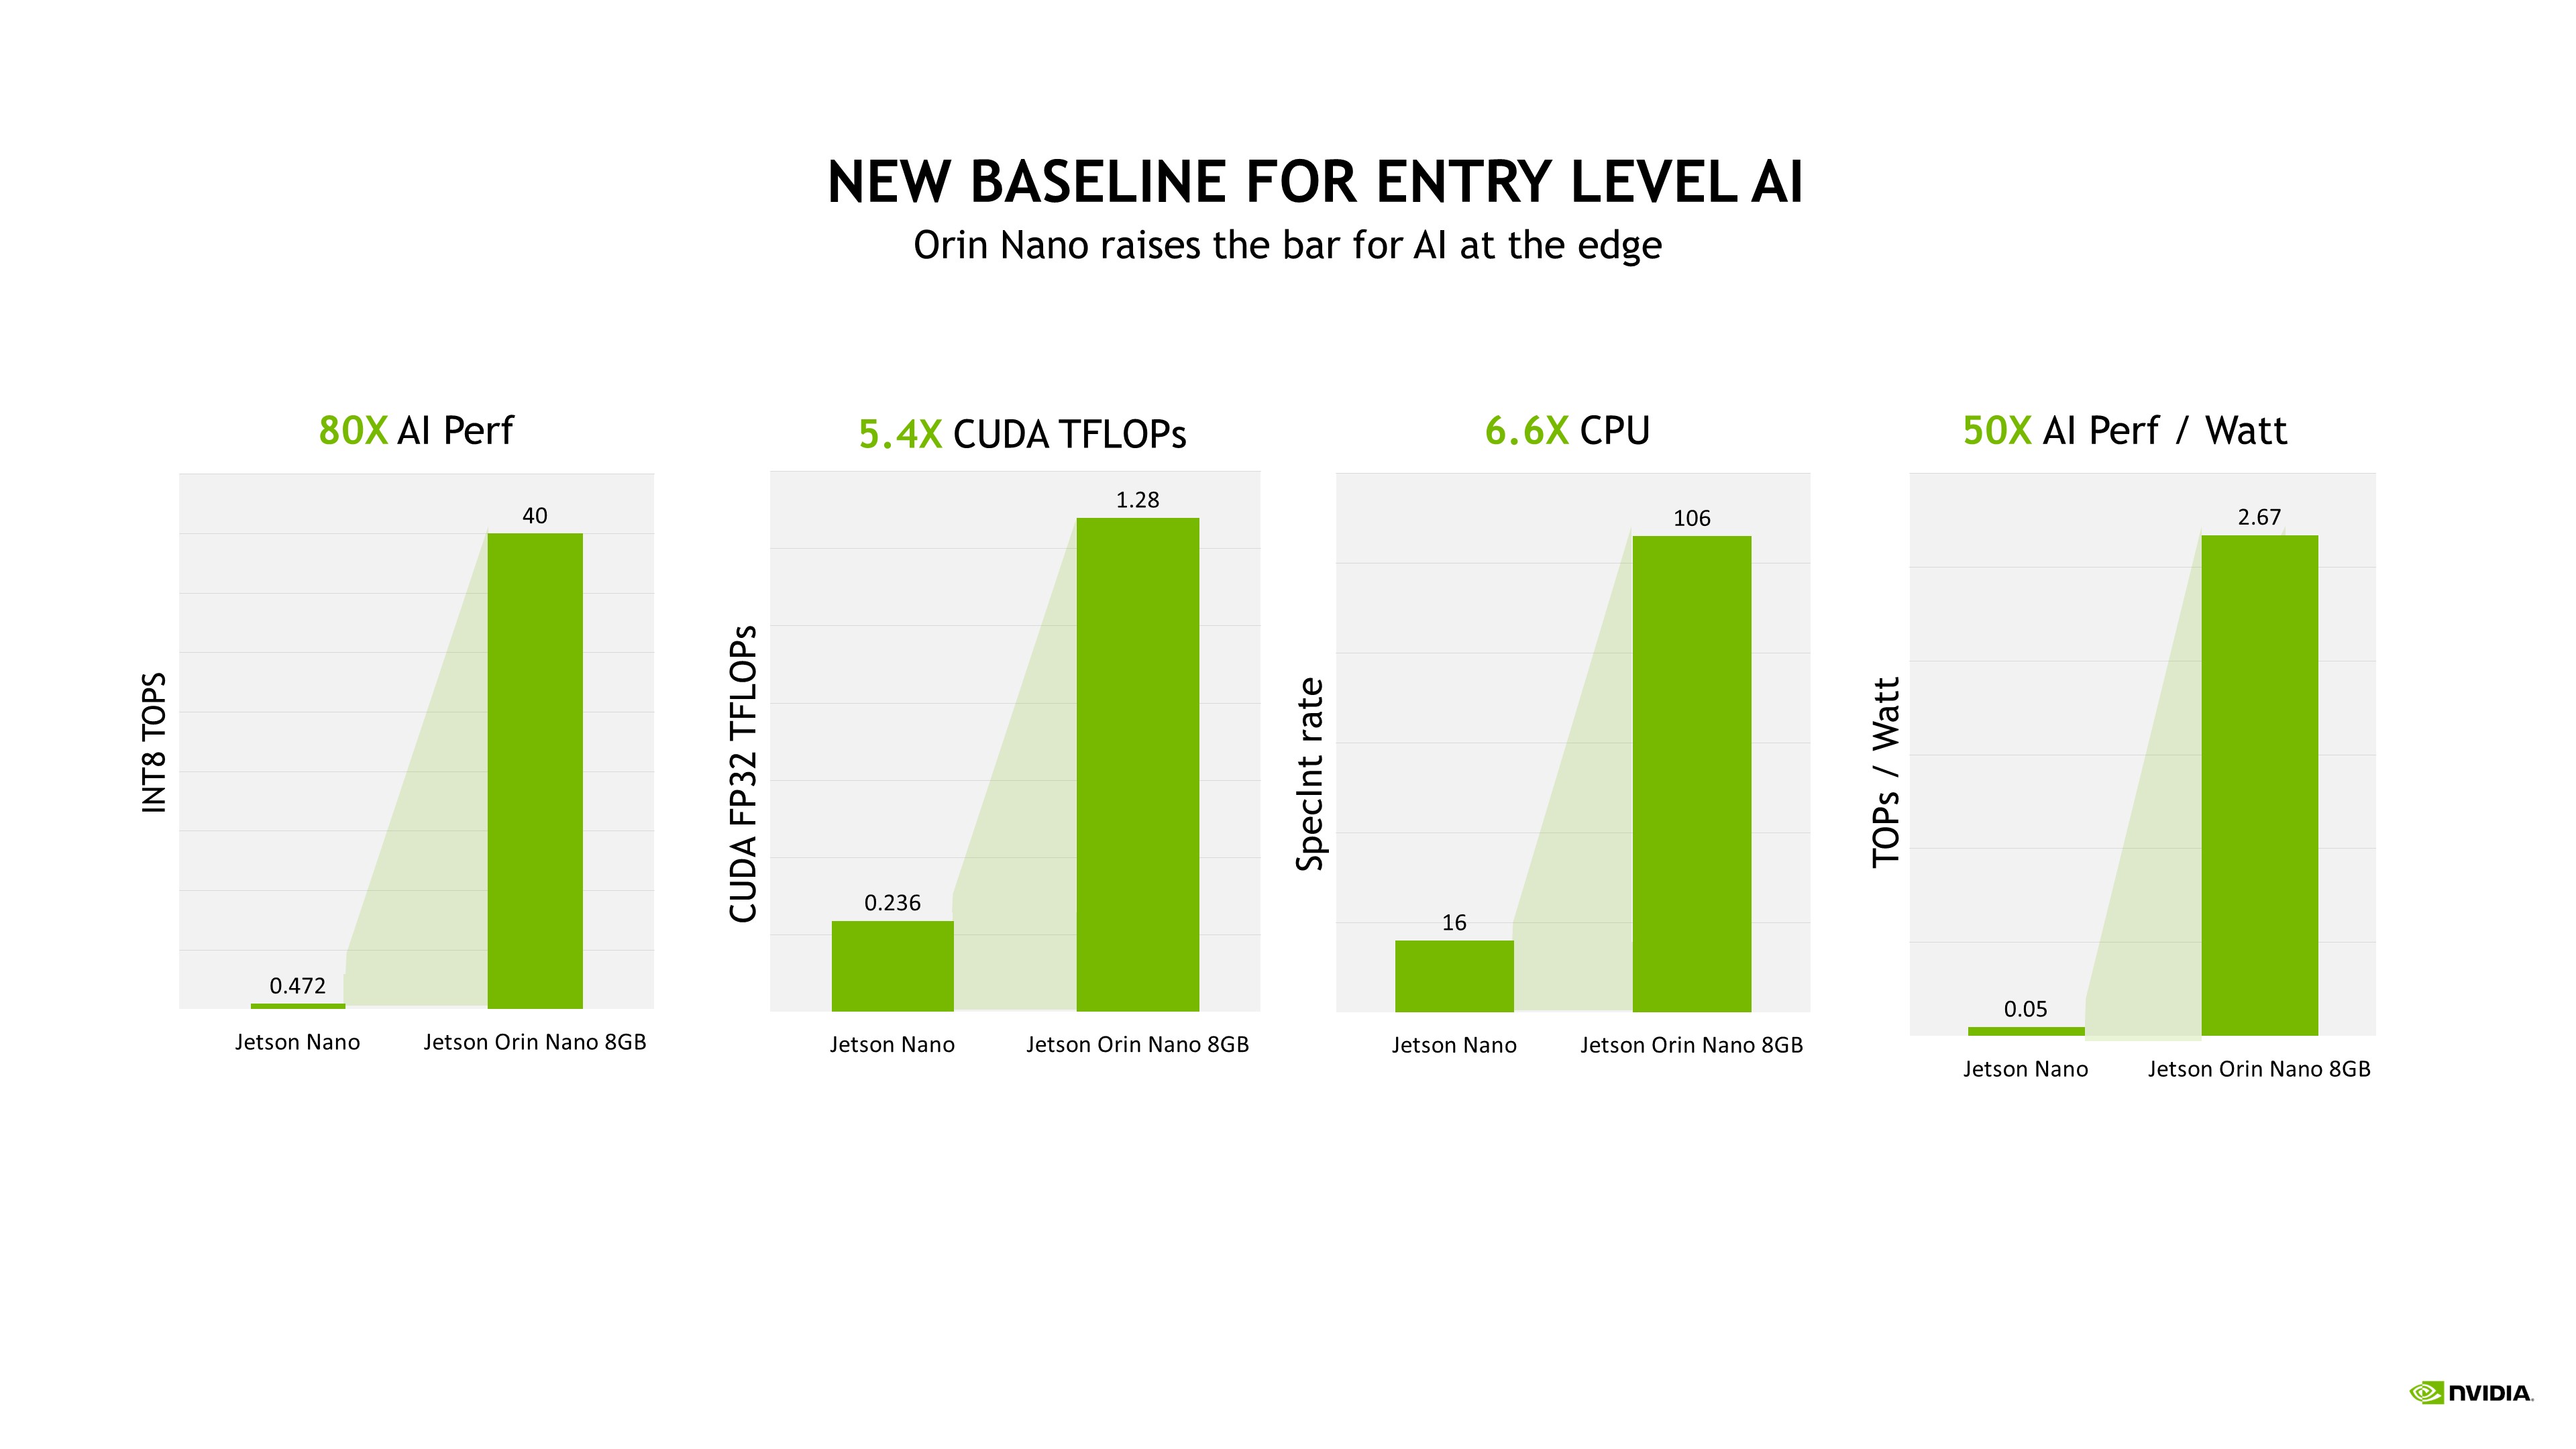
代价在功耗。原版模组功耗范围 7W 到 15W,Super 模式把上限放宽到 25W(官方规格页写的 7W–25W)。算一下能效:40 TOPS / 15W ≈ 2.7 TOPS/W,67 TOPS / 25W ≈ 2.7 TOPS/W,能效其实没变,就是同一块芯片跑得更满。这对部署的含义很直接:如果你的机壳散热是按 15W 设计的,Super 模式不能白拿,要么改散热要么留在原档位。
载板接口逐项过
官方博客给过载板规格表,我逐项抄录核对:摄像头是 2 个 MIPI CSI-2 22-pin 连接器;扩展槽是 M.2 Key M(x4 PCIe Gen3)和 M.2 Key M(x2 PCIe Gen3)各一个,外加 M.2 Key E(PCIe x1、USB 2.0、UART、I2S、I2C)可以插无线网卡;USB 是 4 个 USB 3.2 Gen 2 Type A 加 1 个调试/设备模式共用的 Type C;显示是 DisplayPort 1.2(支持 MST);网络 1 个 GbE;存储靠 microSD 插槽(UHS-1)加外部 NVMe;还有 40-pin 扩展排针(UART、SPI、I2S、I2C、GPIO)、12-pin 按键排针、4-pin 风扇排针和 DC 电源座。
官方实拍图:Super 版开发套件正面,散热风扇与接口布局清晰可见
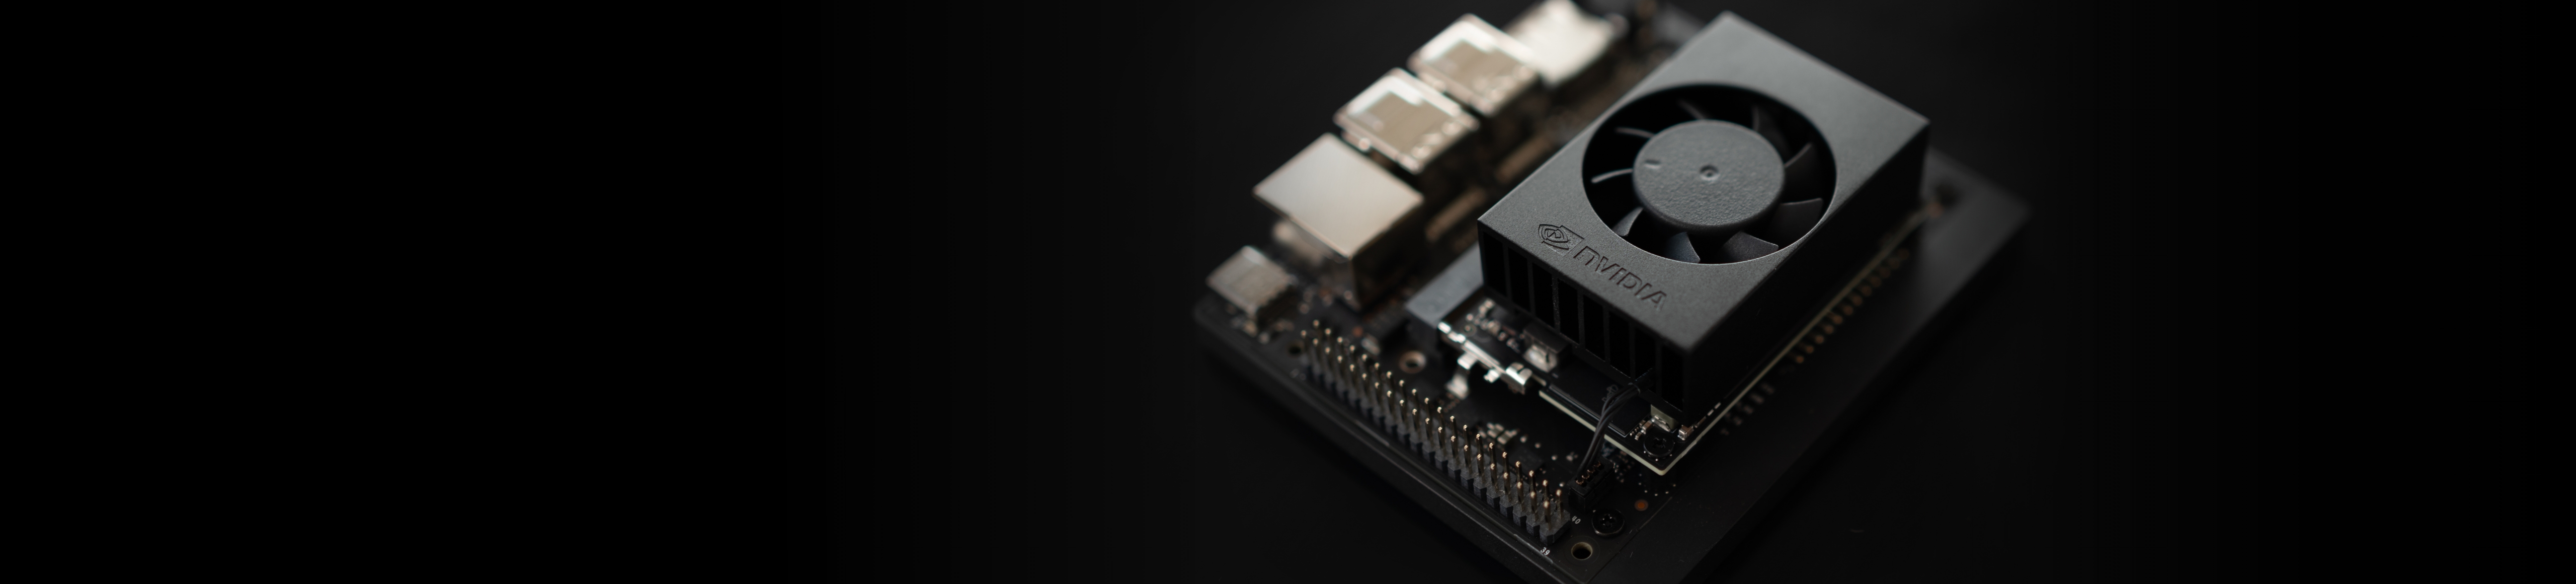
两个接口细节值得点出来。一是调试串口和网络是分开的,Type C 只做调试和设备模式,GbE 单独走——做机器人时主控和上位机的通信链路不会被调试占用。二是 M.2 Key M 两个槽位宽不同,x4 那个给 NVMe 存储比较合理,x2 的空闲出来还能接其他 PCIe 设备,扩展余量在同价位开发板里算宽裕的。
边缘部署建议
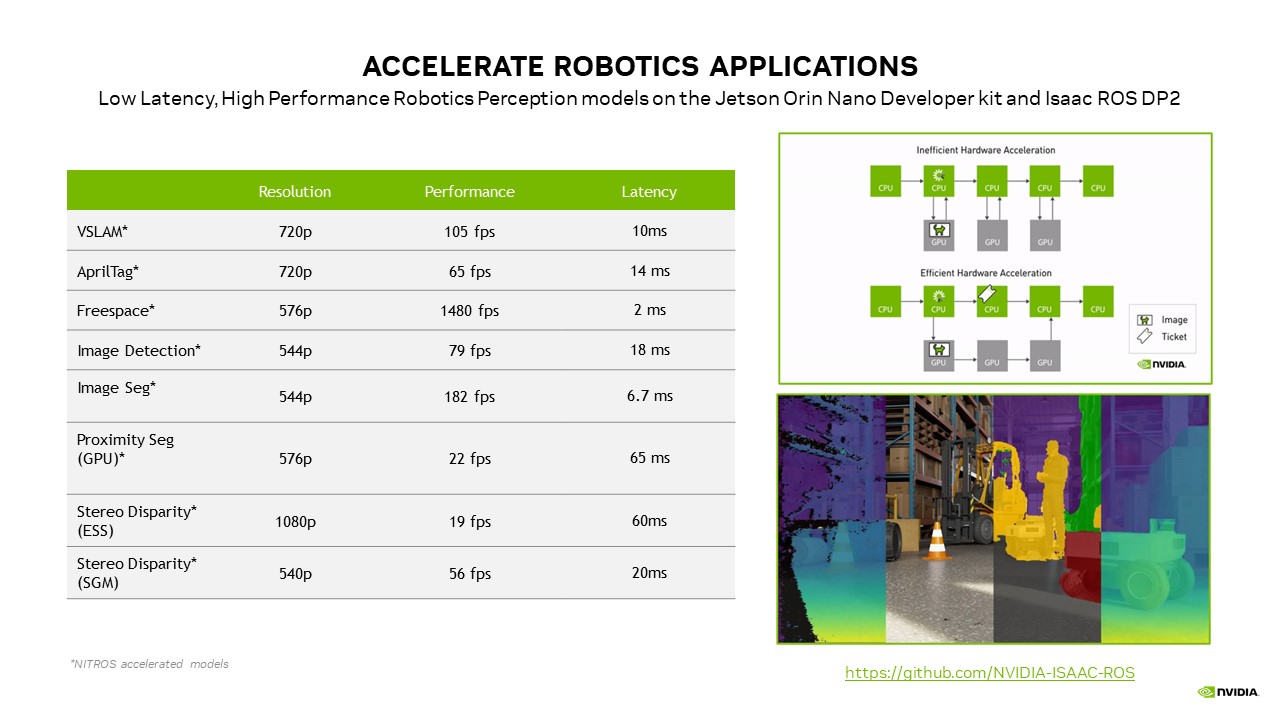
官方博客列了它跑得动的模型:PeopleNet、ActionRecognitionNet、BodyPoseNet 这类视觉模型,配合 Isaac、DeepStream、TAO Toolkit 的软件栈。基于这组官方数据,我的建议分三档:
- 视觉检测/巡检类原型:直接买,249 美元(官方产品页标价,2026 年 11 月 11 日查询)在这个算力档没有对手,JetPack 生态省的时间值回票价。
- 要跑本地大模型的:8GB 内存是硬上限,7B 级量化模型勉强,别指望更大;内存带宽 102 GB/s 是它的天花板,建议确认目标模型再下单。
- 机器人本体部署:先算功耗预算。25W 是芯片功耗,加上载板、摄像头、风扇,整机按 30W 往上留,电池和散热照这个数配。
局限也说清楚:没有预装 eMMC,系统要么装 microSD 要么 NVMe,SD 卡跑系统在长期运行的设备上不太可靠,正式部署建议直接上 NVMe;载板是消费级做工,量产前换自己设计载板时要重新做供电和接口验证。
官方机器人感知模型性能表:Isaac ROS 与 DeepStream 模型在 Orin Nano 上的帧率与延迟
总结一句:这批 Super 升级的本质是"免费的官方超频",硬件没变、生态没变,但把能效曲线重新拉直了。对想在边缘跑生成式 AI 的个人开发者和机器人小团队,它仍然是性价比参考线;只是下单前先问自己一个问题——我的散热扛得住 25W 吗。










散热那段提醒到位,25W 不是闹着玩的,我同事的板子裸跑热降频。
SD 卡跑系统确实不靠谱,我上一个项目半年读写出错两次,直接上 NVMe 了事。
102GB/s 这个带宽升级点讲得好,很多人只盯 TOPS,跑 LLM 的都知道喂得饱不饱看带宽。
我手头这块老 Orin Nano 还在跑,回头升个 JetPack 白嫖 Super,这波官方超频确实厚道。
8GB 内存跑本地模型确实是硬伤,楼上别急着下单,先确认自己要跑的模型再说。