
给一条自己的机械臂训操作策略,卡住人的往往不是机械臂,是选哪个模型。显存多大、手里有多少条演示、要求多高的控制频率,这三件事一确定,能选的范围其实很窄。目前开源能直接拿到权重和代码的主流方案就三个:OpenVLA、Octo、ACT。这三个都不是新东西,但网上把它们放一起比的帖子,很少把评测口径讲清楚,所以这篇按官方页面的原始参数摊开说。
三个对象先摆清楚
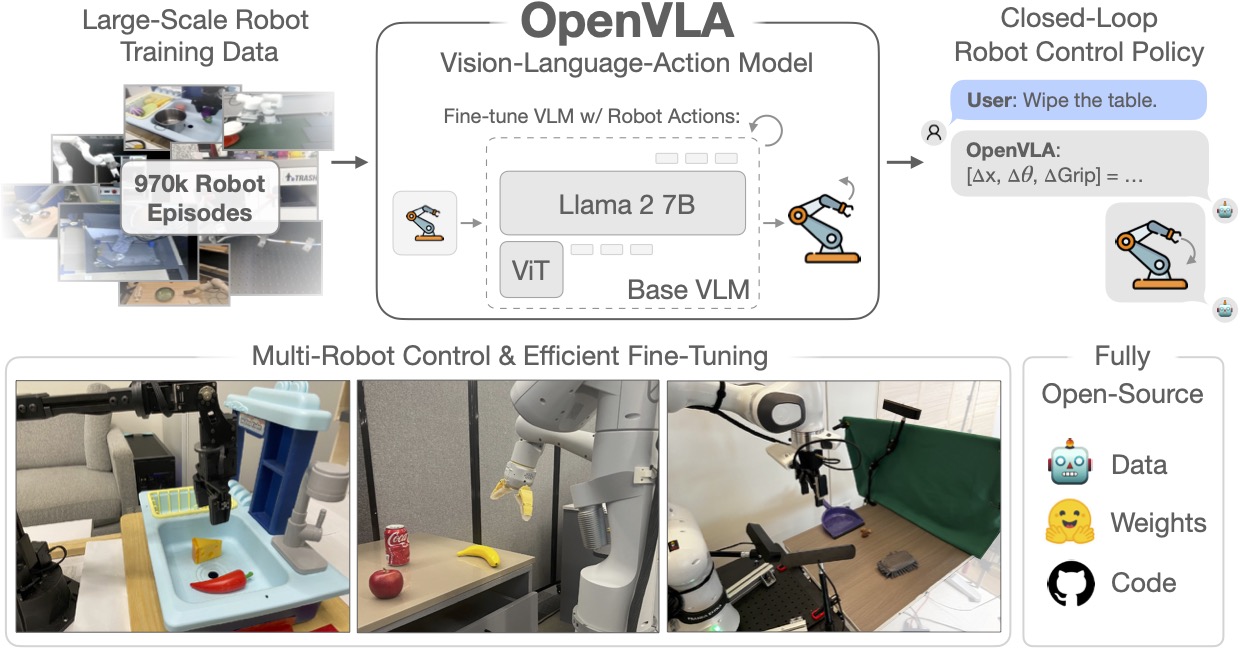
OpenVLA 是 2024 年放出来的 7B 视觉语言动作模型,在 Open X-Embodiment 的 97 万条真机轨迹上训练,权重挂在 HuggingFace。Octo 更早一年,走的是小模型路线,27M 和 93M 两个尺寸,动作输出用扩散,预训练吃了 80 万条轨迹、25 个数据集。ACT 不是模型公司出的产品,是斯坦福和伯克利 ALOHA 项目里的算法,配一套 2 万美元预算的双臂遥操作硬件,主打动作分块。
参数量这一项:OpenVLA 是 7B,Octo 分 27M 和 93M 两个尺寸,ACT 是 CVAE 加 transformer 的轻量结构,规模最小。
动作输出方式:OpenVLA 把动作离散成 token 再解回连续值,Octo 用扩散,ACT 一次预测一整段动作分块。
预训练数据:OpenVLA 吃了 97 万条真机轨迹,Octo 吃了 80 万条、覆盖 25 个数据集,ACT 不做大规模预训练,全靠你自己采的演示。
上手门槛:OpenVLA 官方训练是 64 张 A100 跑 15 天,Octo 单卡可训,ACT 每个任务几十条演示就能起步。
控制频率:OpenVLA 按平台不同是 5Hz 或 15Hz,Octo 按配置走,ACT 直接以 50Hz 预测关节位置。
OpenVLA:7B 换来的语言泛化
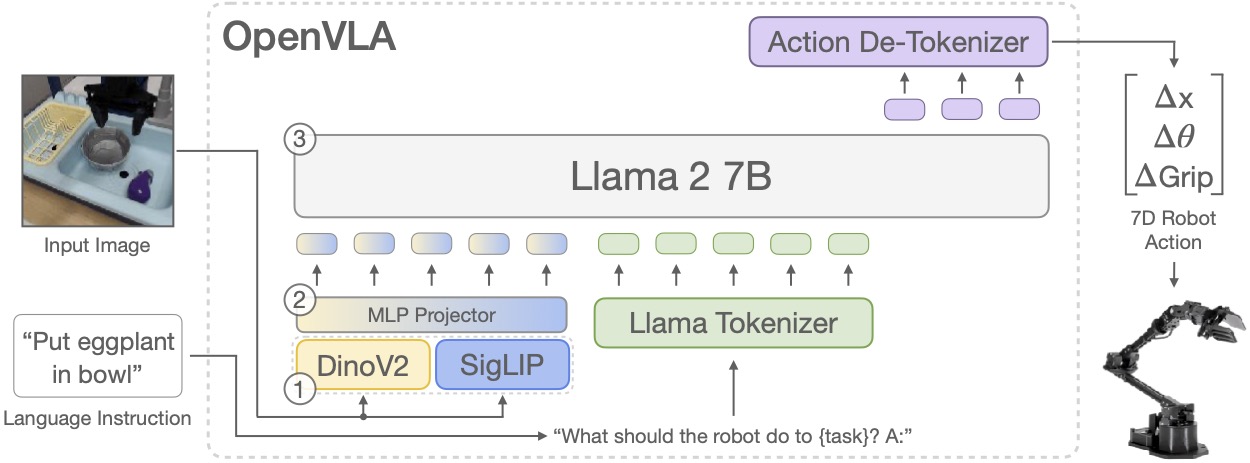
它的结构不复杂,把 SigLIP 和 DINOv2 两个视觉编码器的特征融合,接到 Llama 2 7B 主干上,动作先离散成 token,再解码回连续值。训练用 64 张 A100 跑了 15 天,这个数字很说明问题:它不是你笔记本上能重训的东西。
官方给的效果口径是超过 RT-1-X 和 Octo,在多数任务上也超过 55B 的 RT-2-X,而后者是闭源的。真正对玩家有用的是微调那一行:LoRA 只训 1.4% 的参数,效果和全量微调持平。也就是说,你可以只花一张卡的显存把它迁到自己臂上,前提是显存够放下 7B。官方没写部署最低显存要求,这点得自己试,别照别人的配置单抄。
控制频率上,Franka-Tabletop 平台是 5Hz,Franka-DROID 平台是 15Hz。做抓取放置够了,做需要高频修正的精细活儿会吃力。
Octo:小模型的性价比
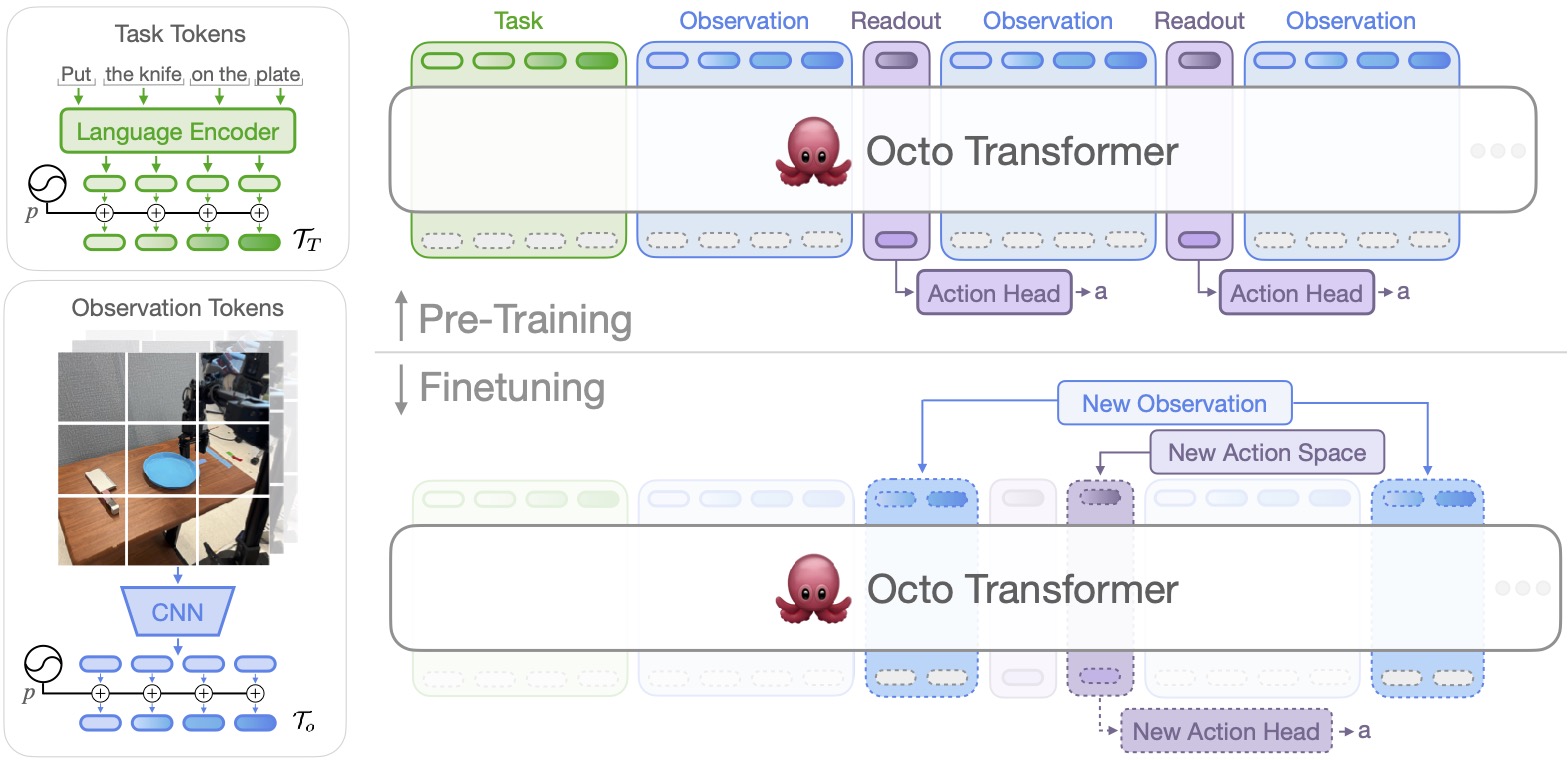
Octo 的思路反过来,不追大。27M 和 93M 两个尺寸,主干是 transformer,动作头用扩散,好处是对观测和动作空间的组合很宽容,换个相机、换个夹爪不用重写网络。预训练吃了 Open X-Embodiment 里 25 个数据集、80 万条轨迹。
零样本数字是 WidowX 0.50、UR5 0.70、RT-1 Robot 0.80,同样条件下 RT-1-X 是 0.20、0.35、0.60。微调侧,每个任务大约 100 条演示,六个任务平均成功率 0.72,从零开始训只有 0.20。另外官方提到加目标图像做条件,在 WidowX 上能涨 25%。
对个人玩家来说这才是关键:单卡能训,100 条演示的采集量一个周末能干完,权重在 HuggingFace 上直接拉。代价是零样本泛化明显不如大模型,换个完全没见过的场景就得补数据。
ACT:只在你那条臂上,它最省事
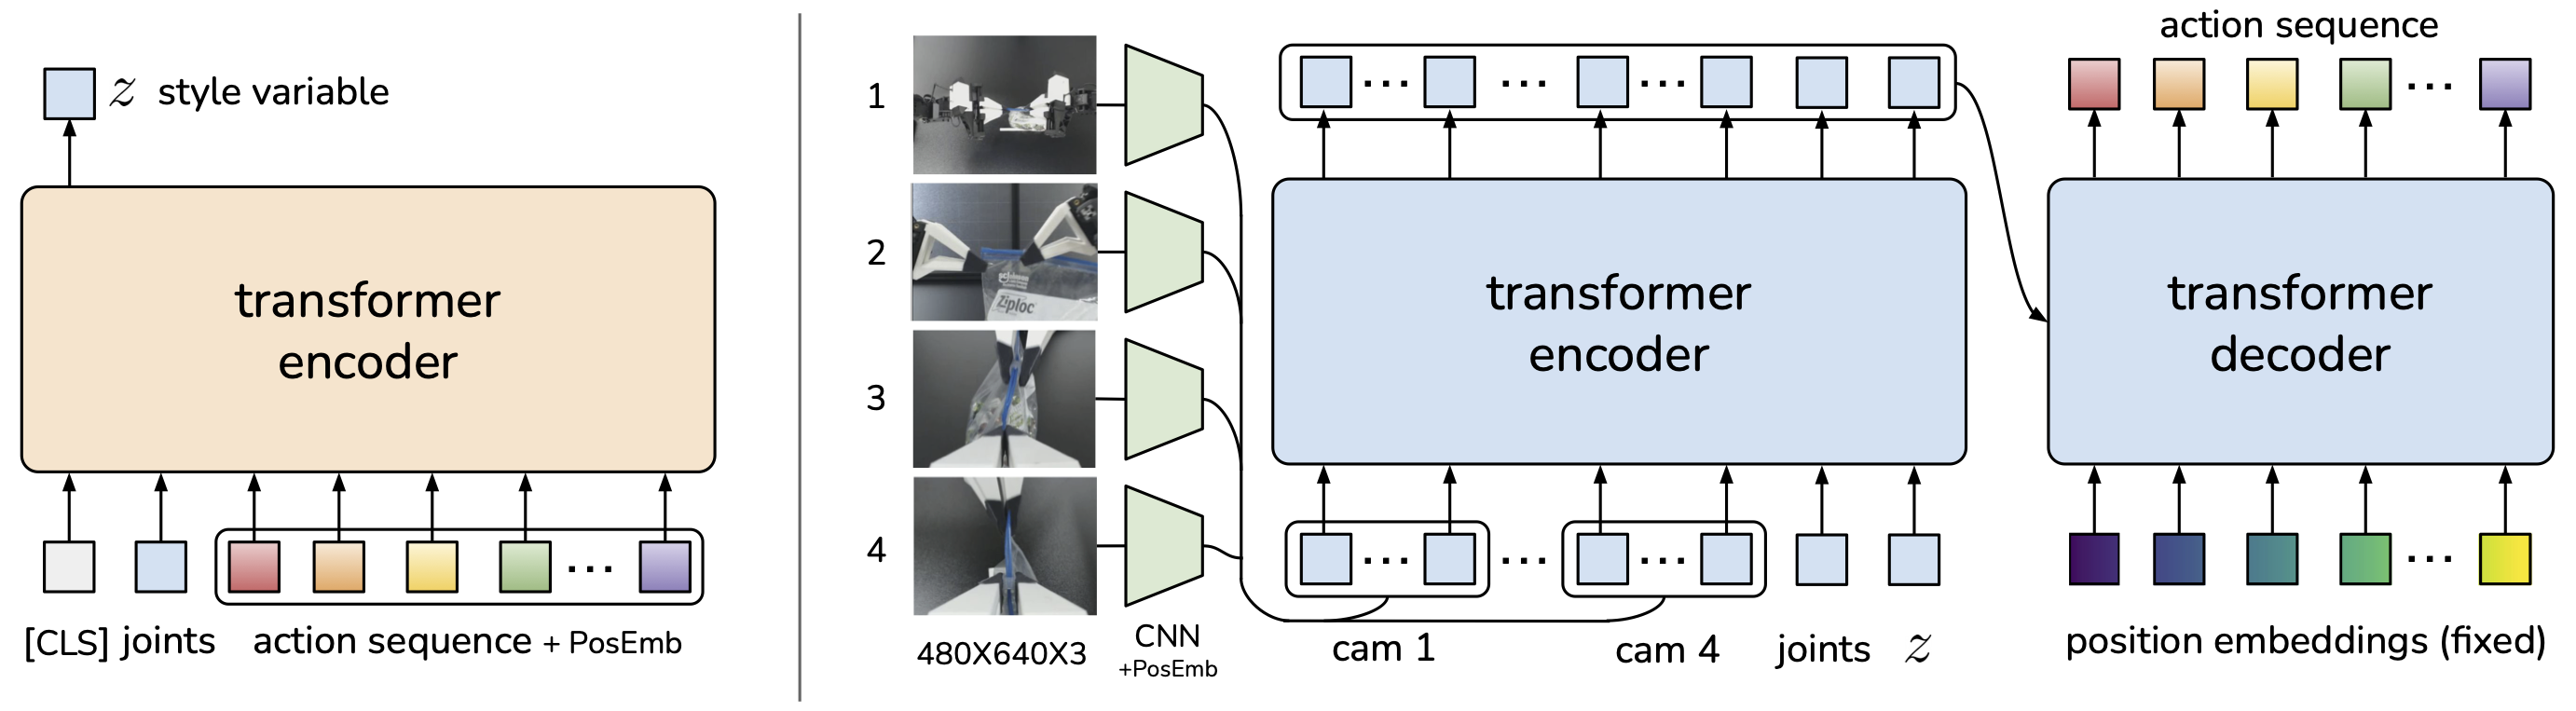
ACT 出自 ALOHA,那套硬件用 2 万美元预算做到了穿扎带、抛乒乓球、装 NIST 板这类活儿。算法核心是别一步一步预测,而是一次预测一串动作,把有效预测长度压下来,误差不容易累积。实现上是条件变分自编码器加 transformer,编码器把动作序列压成一个风格变量,推理时直接把编码器丢掉。
数字很实在:直接以 50Hz 预测关节位置,chunk 固定 90 步,一个 episode 大概 600 到 1000 步。每个任务 50 条演示就够,10 分钟量级的数据在开杯、装电池两个任务上做到 80% 到 90%,四个任务的成功率分别是 96%、84%、64%、92%。观测是 4 路 480x640 相机,两台固定、两台装腕部。
它的短板也很直白:没有跨本体预训练,换任务就得重新采数据,泛化全靠你自己那批演示的覆盖面。
怎么选:按手上的设备分三档
只有一张 24G 卡、任务固定、演示数据自己采,走 ACT。它是三个里闭环最快的,几十条演示能看到动作跑起来,调试成本最低。
还是单卡,但想让一个模型管几个任务、几台不同结构的臂,走 Octo。93M 的体量能塞进单卡,微调门槛是一百条演示级别,泛化靠预训练兜着。
有集群或者云算力,任务要求听懂语言指令、换场景不想重训,走 OpenVLA。7B 换来的就是这层语义理解,LoRA 微调把落地成本压下来了,但推理硬件要提前备好。
三个冷静提示
第一,网上的分数不能横着比。π0 的论文在自家 5 个任务上做过一轮对比,Bussing Easy 这一项里 OpenVLA 是 0,Octo 是 0.043,π0 自己是 0.971,OpenVLA 只在 UR5e 数据上微调后拿到 0.343。看着悬殊,但原因在任务:π0 用的是多阶段、要处理可变形物体的任务,OpenVLA 论文的基准多是单阶段动作。口径不一样,别拿一张表给三家排座次。
第二,能微调不等于能预训练。OpenVLA 的 64 张 A100 跑 15 天,Octo 的 80 万条轨迹,这些成本摊到个人身上是不现实的,所以别指望自己从零训一个通用策略,路只有微调。
第三,授权和商用条款自己核。三个项目都把权重和代码放出来了,但能不能商用、改了要不要回馈,我没在这些页面上看到明确结论,动手之前把仓库里的 LICENSE 看一遍,比事后返工便宜。
我的看法是,先用手上那批数据把 ACT 的闭环走通,跑出第一条能稳定成功的策略,再去谈泛化和语言指令。策略这东西,跑不起来的时候谈架构都是空的。
评测口径这段值得截出来,之前看人拿 π0 的分数去踩 OpenVLA,其实是任务不一样。
Octo 93M 单卡能训这点挺打动我,回头拿自己臂上的数据试一下。
商用条款这条提醒得好,很多人直接拉权重就用了。
ACT 那段最有用,几十条演示就能跑起来,比一上来折腾 7B 现实多了。